Was bedeutet KI-Qualität und Governance?
Es ist die Frage, wie aus einem generierten Entwurf ein veröffentlichungsfähiger Inhalt wird. Vier Bausteine tragen das: eine beschriebene Markensprache aus Entscheidungen statt Adjektiven, geprüfte Beispieltexte, eine Ausschlussliste konkreter Formulierungen und ein Prüfschritt vor der Freigabe.
Die Reihenfolge ist nicht beliebig. Wer mit dem Prüfschritt beginnt, ohne die ersten drei Bausteine zu haben, prüft gegen ein Gefühl. Genau daraus entstehen die Diskussionen, die niemand auflösen kann.
Warum lösen bessere Anweisungen das Problem nicht?
Weil die Ursache im fehlenden Kontext liegt, nicht in der Formulierung des Prompts. Ein Sprachmodell wählt den wahrscheinlichsten nächsten Textbaustein und unterscheidet dabei nicht zwischen einer Aussage, die es belegen kann, und einer, die nur gut ins Muster passt. Wo eine Angabe fehlt, wird sie ergänzt.
Daraus folgt eine praktische Regel: Wenn dieselbe Falschangabe zum zweiten Mal auftaucht, ist die richtige Reaktion nicht eine bessere Anweisung, sondern ein Eintrag in der Wissensbasis. Jede so behobene Stelle taucht nicht wieder auf.
Woran prüft ihr, bevor ihr freigebt?
An acht Kriterien in drei Gruppen: Fakten, Marke und Recht. Jedes Kriterium hat genau eine Zuständigkeit und ein Ja-Nein-Ergebnis. Damit dauert eine Prüfung unter zehn Minuten statt drei bis fünf Tage mit Rückfragen, und die Rückmeldung wird eindeutig.
Ebenso wichtig ist der Umgang mit dem Ergebnis. Drei Schweregrade legen vorher fest, was eine Veröffentlichung stoppt und was nicht. Ohne diese Abstufung wird jede Anmerkung zur Vollbremsung.
Was ist rechtlich verbindlich?
Seit dem 2. August 2026 gelten die Transparenzbestimmungen aus Artikel 50 der KI-Verordnung unmittelbar. Sie treffen synthetische Bilder, Stimmen und Videos deutlich härter als gewöhnliche Marketingtexte, für die die Kennzeichnungspflicht enger gefasst ist als vielfach angenommen.
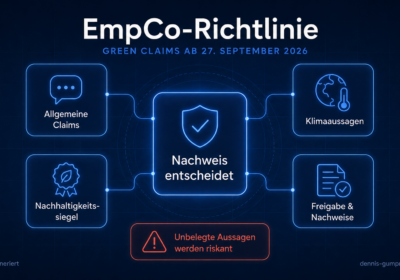
Davon getrennt regelt die EmpCo-Richtlinie, welche Umweltaussagen gegenüber Verbrauchern zulässig sind. Beides sind eigene Regelwerke mit eigenen Nachweispflichten. Diese Beiträge fassen den Rahmen vereinfacht zusammen und ersetzen keine Rechtsberatung.
Häufige Fragen
Müssen wir KI-generierte Texte kennzeichnen?
Das hängt vom Einzelfall ab. Die Kennzeichnungspflicht für Texte zielt auf Inhalte, die über Angelegenheiten von öffentlichem Interesse informieren. Ein Produkttext, ein Ratgeberbeitrag oder ein Kundenbrief fällt in aller Regel nicht darunter. Unabhängig davon lohnt sich eine eigene, dokumentierte Festlegung, weil sie auch dann verteidigbar ist, wenn sich die Auslegung später ändert.
Lässt sich die Fehlerquote auf null senken?
Nein. Das Erzeugen des wahrscheinlichsten Textbausteins ist der Mechanismus selbst, nicht ein Defekt. Steuerbar ist dagegen, wo Fehler auftreten: bei Aussagen über euer Unternehmen, bei konkreten Zahlen mit Quellenangabe und bei rechtlichen Angaben. Genau dort prüft ihr gezielt statt überall gleich intensiv.
Kann KI die Prüfung selbst übernehmen?
Teilweise. Der Abgleich gegen eine Ausschlussliste ist eine Suchaufgabe und braucht kein Sprachmodell. Auch zeitbezogene Aussagen ohne Datumsangabe findet ein Modell zuverlässig. Ob eine Aussage über euer Unternehmen zutrifft, weiß dagegen nur euer Unternehmen.
Wo fangt ihr am besten an?
Bei der Wissensbasis, nicht bei den Prompts. Nehmt die letzten zehn Texte und notiert jede Angabe, die jemand nachschlagen musste oder die in der Freigabe beanstandet wurde. Diese Liste ist eure erste Fassung und löst von Anfang an reale Probleme statt hypothetischer.
Weiter im Thema
Wenn die Qualität stimmt, aber der Ablauf drumherum hängt, geht es weiter in Content Operations.
Wenn ihr Werkzeuge sucht, die Kontext und Prüfung abbilden, findet ihr die Entscheidungsgrundlagen in Toolauswahl und Business Case.
Wenn bei euch gerade die Frage ansteht, wie KI-Inhalte belastbar und markenkonform werden, schauen wir uns eure Situation gemeinsam an.
Gespräch buchenZuletzt aktualisiert: 5. September 2026