Der Entwurf für die Produktseite liest sich gut. Flüssig, strukturiert, im richtigen Ton. Im dritten Absatz steht, dass eure Lösung sich in unter zehn Minuten einrichten lässt.
Das stimmt nicht. Es hat auch nie jemand behauptet. Das Modell hat es ergänzt, weil es bei vergleichbaren Produkten üblich ist. Es hatte keine Möglichkeit, es besser zu wissen, denn ihr habt ihm nie gesagt, was tatsächlich stimmt.
Eine Wissensbasis ist die Sammlung gesicherter Angaben über euer Unternehmen, eure Produkte und eure Zielgruppen, auf die bei jeder Texterstellung zugegriffen wird. Sie beantwortet die Frage, was stimmt. Die Markensprache beantwortet dagegen, wie ihr klingt. Erst beide zusammen ergeben Texte, die zu euch passen und inhaltlich tragen.
Warum bessere Anweisungen das Problem nicht lösen
Die übliche Reaktion auf falsche Angaben lautet: Wir müssen genauer formulieren. Das hilft im Einzelfall und skaliert nicht. Wer jede Produktangabe in die Anweisung schreibt, schreibt den Text im Grunde selbst, nur umständlicher.
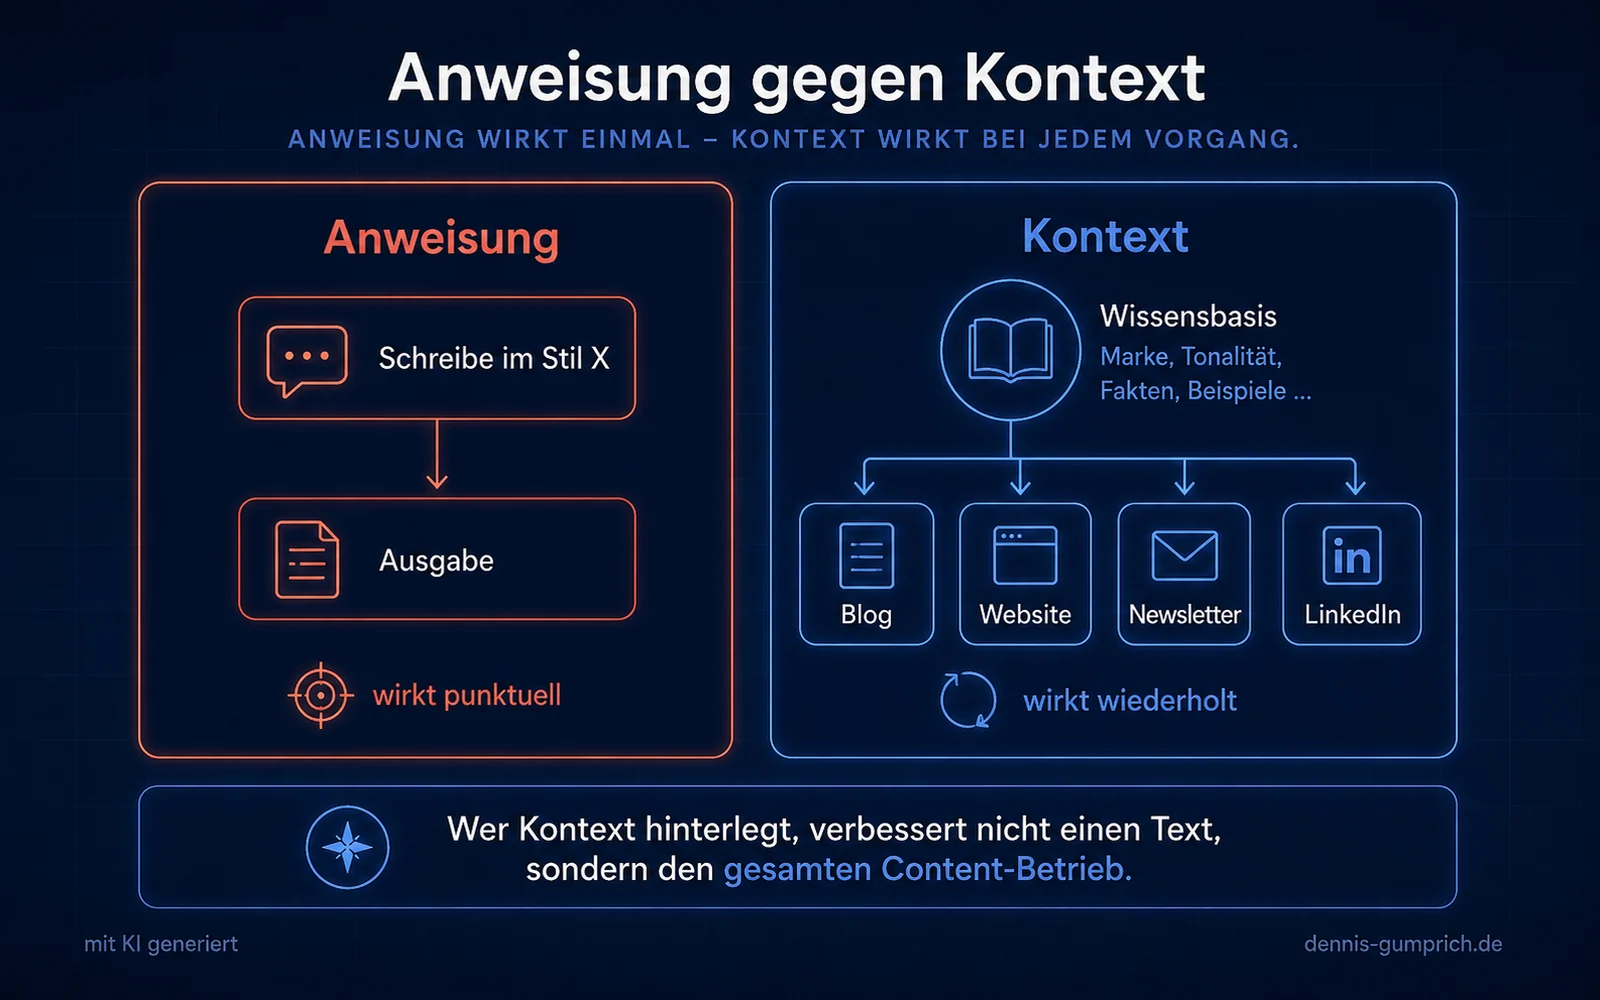
Der strukturelle Unterschied liegt zwischen Anweisung und Kontext. Eine Anweisung gilt für einen Vorgang und existiert danach nicht mehr. Kontext liegt hinterlegt vor und wirkt bei jedem Vorgang, unabhängig davon, wer ihn auslöst und wie gut diese Person formuliert. Genau das ist der Grund, warum Teams mit gepflegtem Kontext bessere Ergebnisse erzielen als Teams mit besseren Formulierungen.
Hinzu kommt ein Verteilungseffekt. Anweisungen leben in den Köpfen einzelner Personen. Wenn die Kollegin mit dem guten Vorgehen im Urlaub ist, sinkt die Ergebnisqualität sofort. Hinterlegter Kontext wirkt für alle gleich, auch für Personen, die sich mit dem Thema gar nicht beschäftigen wollen.
Praktisch heißt das: Wenn dieselbe Falschangabe zum zweiten Mal auftaucht, ist die richtige Reaktion nicht eine bessere Anweisung, sondern ein Eintrag in der Wissensbasis. Jede so behobene Stelle taucht nicht wieder auf. Welche Arten von Falschangaben dabei typischerweise entstehen, steht in Halluzinationen im Marketing-Text systematisch abfangen.
Was gehört in eine KI-Wissensbasis?
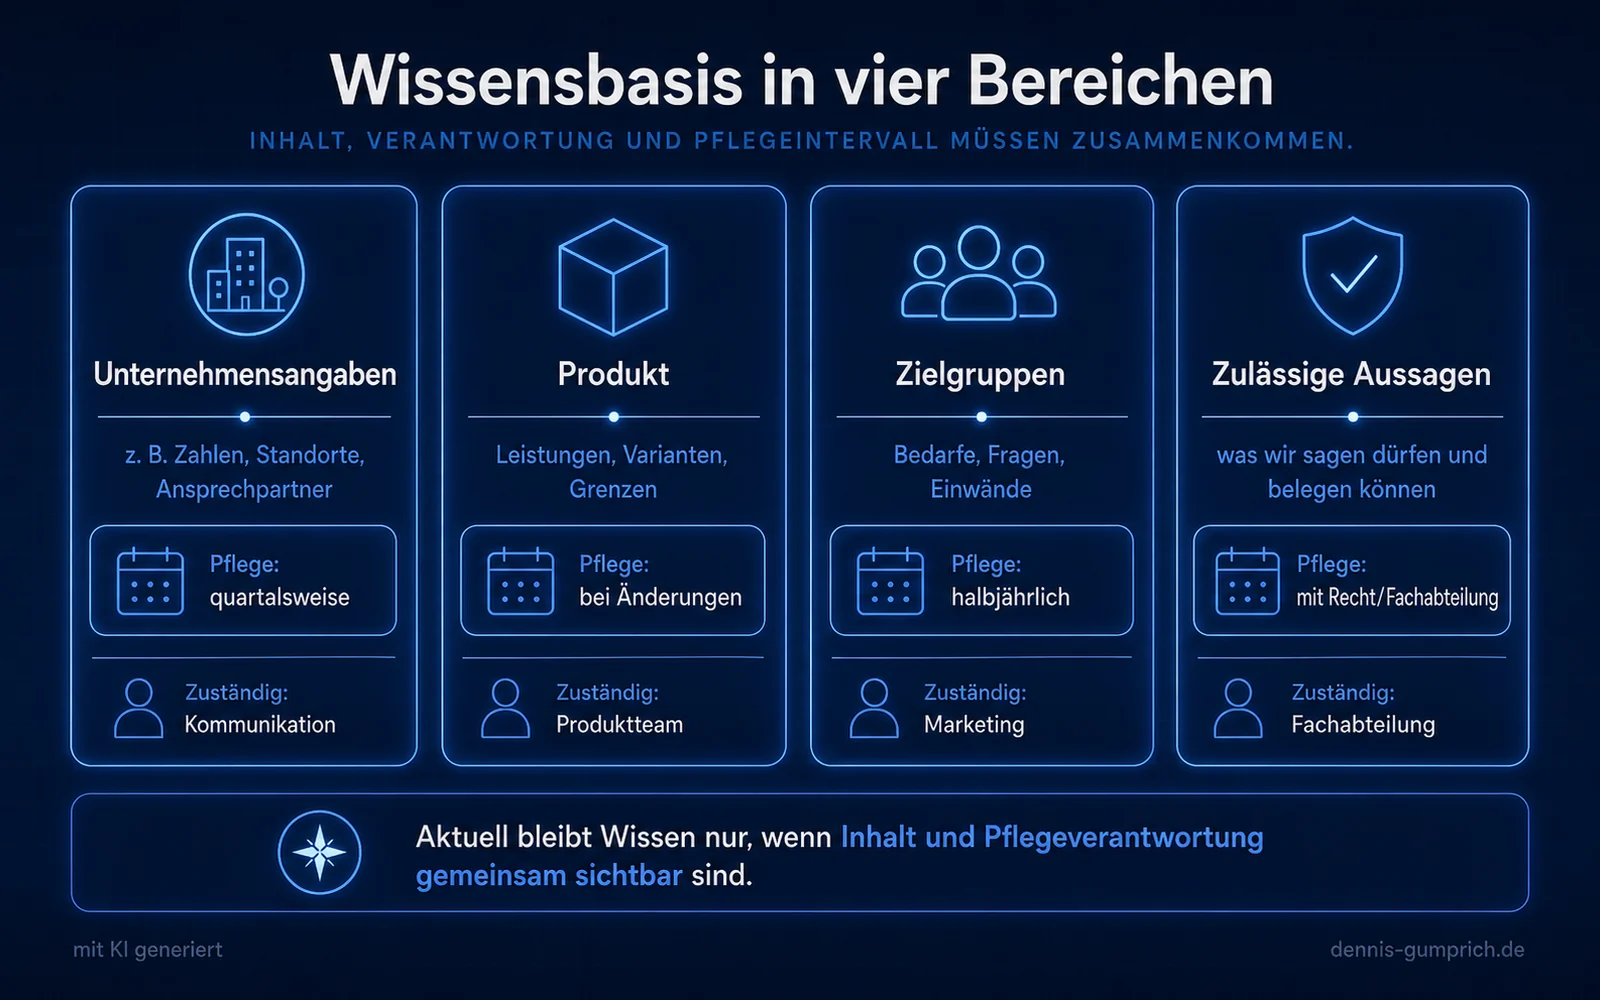
Gesicherte, freigegebene Angaben in klar getrennten Bereichen: Unternehmensangaben wie Gründungsjahr, Standorte, Zertifizierungen und Referenzkunden mit Freigabestatus. Produkt und Leistung, inklusive dessen, was ausdrücklich nicht enthalten ist. Zielgruppen und Anlässe mit den Einwänden, die regelmäßig kommen. Am schnellsten wirken die Unternehmensangaben, weil sie am häufigsten falsch ergänzt werden.
Unternehmensangaben
Gründungsjahr, Standorte, Mitarbeitendenzahl, Zertifizierungen, Auszeichnungen, Referenzkunden mit Freigabestatus.
Wirkt sofort: Diese Angaben werden am häufigsten falsch ergänzt.
Produkt und Leistung
Funktionsumfang, offizielle Bezeichnungen, Preismodell, was ausdrücklich nicht enthalten ist, geplante Erweiterungen mit Status.
Wirkt sofort: Verhindert erfundene Funktionen und falsche Versprechen.
Zielgruppen und Anlässe
Wer kauft, wer entscheidet mit, welche Auslöser es gibt, welche Einwände regelmäßig kommen und wie ihr sie beantwortet.
Wirkt mittelfristig: Macht Texte konkret statt allgemein.
Zulässige Aussagen
Welche Wirkungsaussagen belegt und freigegeben sind, welche Vergleiche zulässig sind, welche Formulierungen die Rechtsabteilung ausgeschlossen hat. Bei Umweltaussagen gehört zusätzlich der hinterlegte Nachweis dazu, die Anforderungen stehen in EmpCo-Richtlinie: was die EU-Vorgaben für Green Claims ab 2026 bedeuten.
Kritisch, wenn es fehlt: Hier entstehen die teuersten Fehler.
Ein fünfter Bereich wird oft vergessen und ist besonders wertvoll: eure eigenen Zahlen mit Herkunft und Stand. Nicht die Zahl allein, sondern die Zahl mit Datum und Quelle. Ohne diese Zusätze wird sie irgendwann in einem Text auftauchen, in dem sie nicht mehr stimmt.
Was gehört ausdrücklich nicht hinein?
Personenbezogene Daten von Kundinnen und Kunden, unveröffentlichte Preise, interne Strategiepapiere, Vertragsdetails und alles ohne Freigabe. Der Maßstab ist einfach: Hinein gehört, was ihr auch einer neuen Kollegin am ersten Tag geben würdet. Denn was in der Wissensbasis liegt, kann in einem Text landen.
Eine Wissensbasis wird schnell zur Ablage für alles. Das ist aus zwei Gründen ein Problem: Sie wird unbrauchbar, und sie wird zum Risiko.
Gesicherte, freigegebene Angaben, die in Texten vorkommen dürfen. Alles, was ihr auch einer neuen Kollegin am ersten Tag geben würdet.
Personenbezogene Daten von Kundinnen und Kunden, unveröffentlichte Preise, interne Strategiepapiere, Vertragsdetails, alles ohne Freigabe.
Der zweite Punkt betrifft nicht nur den Datenschutz, sondern auch die Praxis. Was in der Wissensbasis liegt, kann in einem Text landen. Das ist ihr Zweck. Deshalb ist die Aufnahme eine bewusste Freigabeentscheidung und keine Ablagefrage.
Legt vor dem Befüllen fest, wer Inhalte aufnehmen darf und welche Angaben eine Freigabe brauchen. Wenn die Wissensbasis mit externen Diensten verarbeitet wird, klärt vorher mit eurer Datenschutzstelle, welche Inhaltsarten zulässig sind. Diese Klärung dauert deutlich kürzer, wenn sie vorher stattfindet.
Aktualität ist das eigentliche Problem
Eine Wissensbasis aufzubauen dauert wenige Tage. Sie aktuell zu halten, entscheidet darüber, ob sie nach einem Jahr noch etwas wert ist. Eine veraltete Wissensbasis ist gefährlicher als gar keine, weil ihre Angaben ungeprüft übernommen werden.
| Inhalt | Ändert sich | Pflegeintervall | Zuständig |
|---|---|---|---|
| Unternehmensangaben | selten | jährlich | Unternehmenskommunikation |
| Funktionsumfang und Bezeichnungen | häufig | bei jedem Release | Produktverantwortliche |
| Preise und Konditionen | mittel | quartalsweise | Vertrieb |
| Zulässige Aussagen | selten, aber folgenreich | jährlich und anlassbezogen | Rechtsabteilung |
| Eigene Zahlen | jährlich | mit Stand-Datum versehen | Marketing |
Die vierte Spalte ist die entscheidende. Eine Wissensbasis ohne benannte Zuständigkeiten wird von niemandem gepflegt, weil sie allen gehört. Verteilt die Verantwortung nach Fachgebiet, nicht auf eine zentrale Person, die ohnehin nicht beurteilen kann, ob eine Produktangabe noch stimmt.
Wie fangt ihr mit einer Wissensbasis klein an?
Der häufigste Grund, warum eine Wissensbasis nie entsteht, ist der geplante Umfang. Wer alles sammeln will, beginnt nicht. Der Einstieg, der funktioniert, ist deutlich kleiner: Nehmt die letzten zehn Texte und notiert jede Angabe, die jemand nachschlagen oder erfragen musste. Diese Liste ist eure erste Fassung.
Der zweite Zugang ist die Fehlerseite. Sammelt jede Falschangabe, die in den letzten Monaten in einem Entwurf stand. Jede davon wird zu einem Eintrag mit der korrekten Angabe. Damit löst die Wissensbasis von Anfang an reale Probleme statt hypothetische. Wie ihr denselben Kontext im einzelnen Prompt mitgebt, steht in Der ultimative Guide: ChatGPT im SEO und Content Marketing.
Wer sollte die Wissensbasis pflegen?
Geteilt nach Fachgebiet, nicht zentral bei einer Person und nicht bei niemandem. Eine zentrale Redaktionsperson kann nicht beurteilen, ob eine Funktionsbezeichnung nach dem letzten Release noch stimmt oder ob eine Wirkungsaussage weiterhin freigegeben ist. Sie kann nur nachfragen, und irgendwann tut sie das nicht mehr.
Die Zuständigkeitsfrage entscheidet darüber, ob eine Wissensbasis nach einem Jahr noch stimmt. In der Praxis scheitern die meisten an einer von zwei Varianten: Entweder ist niemand zuständig, oder eine einzelne Person ist für alles zuständig.
Der erste Fall ist offensichtlich, der zweite wird unterschätzt. Eine zentrale Redaktionsperson kann nicht beurteilen, ob eine Funktionsbezeichnung nach dem letzten Release noch stimmt oder ob eine Wirkungsaussage weiterhin freigegeben ist. Sie kann nur nachfragen, und das tut sie irgendwann nicht mehr.
Tragfähig ist eine geteilte Verantwortung nach Fachgebiet mit einer koordinierenden Rolle. Die Produktverantwortlichen halten Funktionsangaben aktuell, der Vertrieb Preise und Konditionen, die Rechtsabteilung zulässige Aussagen. Das Marketing koordiniert, erinnert an Termine und pflegt die eigenen Zahlen. Wichtig ist, dass jede Rolle nur ihren Bereich verantwortet und nicht die Vollständigkeit des Ganzen.
Ein praktischer Zusatz: Vermerkt bei jedem Eintrag, wann er zuletzt bestätigt wurde. Nicht wann er geändert wurde, sondern wann zuletzt jemand bestätigt hat, dass er noch stimmt. Diese Angabe macht sofort sichtbar, welche Teile ungeprüft alt geworden sind.
Fünf Fehler beim Aufbau
- Alles sammeln wollenEine vollständige Wissensbasis wird nie fertig und deshalb nie genutzt. Vier Bereiche und zwei Tage Aufwand reichen für den Start.
- Angaben ohne Stand-DatumEine Zahl ohne Zeitpunkt wird irgendwann in einem Text verwendet, in dem sie nicht mehr stimmt. Das Datum gehört zur Angabe.
- Zentrale PflegeEine einzelne Person kann nicht beurteilen, ob eine Produktangabe oder eine Rechtsaussage noch aktuell ist. Verteilt die Verantwortung nach Fachgebiet.
- Vertrauliches mit aufnehmenWas in der Wissensbasis liegt, kann in einem Text landen. Die Aufnahme ist eine Freigabeentscheidung.
- Fehler einzeln korrigierenWer dieselbe Falschangabe dreimal im Text korrigiert, statt sie einmal in der Wissensbasis zu hinterlegen, arbeitet dauerhaft gegen dasselbe Problem.
In fünf Schritten zur nutzbaren Wissensbasis
- Tag 1Nachschlagebedarf erhebenLetzte zehn Texte durchgehen und jede Angabe notieren, die jemand erfragen oder suchen musste. Das ist die Rohliste.
- Tag 1Falschangaben ergänzenJede bekannte Fehlangabe aus den letzten Monaten mit der korrekten Fassung aufnehmen.
- Tag 2Freigaben einholenProduktangaben durch die Produktverantwortlichen, Wirkungsaussagen durch die Rechtsabteilung bestätigen lassen. Ohne Freigabe kein Eintrag.
- Tag 3An den Arbeitsort bringenDorthin, wo Texte entstehen, nicht in ein separates Dokument. Was gesucht werden muss, wird nicht verwendet.
- Ab Woche 2Pflege verankernJe Bereich eine zuständige Rolle und ein Intervall. Zusätzlich die Regel: Jede gefundene Falschangabe wird sofort eingetragen.
Der fünfte Schritt enthält den eigentlichen Mechanismus. Wenn jede entdeckte Falschangabe zu einem Eintrag wird, sinkt die Fehlerquote mit jedem Beitrag. Die Wissensbasis wird dann nicht durch ein Projekt vollständig, sondern durch den laufenden Betrieb. Wie sich das in den gesamten Produktionsablauf einfügt, steht in Markenkonforme KI-Inhalte: der Leitfaden für Marketingverantwortliche.
Selbstcheck: Wie belastbar ist euer Kontext?
Setzt Haken bei allem, was auf euch zutrifft.
Vorschlag, wie wir falsche Angaben in Textentwürfen dauerhaft abstellen:
Das Problem löst sich nicht durch bessere Formulierungen im Einzelfall. Was fehlt, ist hinterlegter Kontext: gesicherte Angaben zu Unternehmen, Produkt, Zielgruppen und zulässigen Aussagen, auf die bei jeder Texterstellung zugegriffen wird.
Wir beginnen klein: Aus den letzten zehn Texten sammeln wir jede Angabe, die jemand nachschlagen musste, dazu jede bekannte Falschangabe mit der korrekten Fassung. Produktangaben lassen wir durch die Produktverantwortlichen bestätigen, Wirkungsaussagen durch die Rechtsabteilung.
Aufwand: zwei bis drei Tage für den Aufbau. Danach je Bereich eine zuständige Rolle für die Pflege. Vertrauliche Inhalte und personenbezogene Daten nehmen wir ausdrücklich nicht auf.
Fazit: Kontext ist die Investition, Anweisungen sind der Aufwand
Wer in Anweisungen investiert, investiert in einen Vorgang. Wer in Kontext investiert, investiert in jeden künftigen Vorgang. Der Unterschied zeigt sich nicht beim ersten Text, sondern beim fünfzigsten und besonders dann, wenn eine neue Person im Team beginnt oder eine erfahrene ausfällt.
Häufige Fragen
Worin unterscheidet sich das von der Markensprache?
Die Markensprache beantwortet, wie ihr klingt: Anrede, Satzbau, zulässige Stilmittel. Die Wissensbasis beantwortet, was stimmt: Angaben, Zahlen, Funktionsumfang. Beides gehört an denselben Ort, ist aber inhaltlich zu trennen, weil unterschiedliche Personen dafür zuständig sind.
In welchem Format legen wir das an?
Entscheidend ist nicht das Format, sondern die Zugriffsstelle. Solange der Kontext dort verfügbar ist, wo Texte entstehen, funktioniert eine strukturierte Datei ebenso wie eine Plattformfunktion. Vermeidet mehrere parallele Fassungen, das ist der häufigste Fehler.
Wie umfangreich sollte sie sein?
So knapp wie möglich. Eine überladene Wissensbasis erschwert die Pflege und führt dazu, dass veraltete Einträge unbemerkt bleiben. Nehmt auf, was tatsächlich in Texten vorkommt, nicht was theoretisch relevant sein könnte.
Dürfen wir Kundendaten aufnehmen?
Personenbezogene Daten gehören nicht hinein. Referenzkunden nur mit dokumentierter Freigabe und in der Form, die freigegeben wurde. Wenn die Wissensbasis mit externen Diensten verarbeitet wird, klärt die zulässigen Inhaltsarten vorher mit eurer Datenschutzstelle.
Woran merken wir, dass sie wirkt?
An der Zahl der Nachfragen und an den Beanstandungen in der Freigabe. Wenn dieselbe Angabe nicht mehr erfragt wird und dieselbe Falschangabe nicht mehr auftaucht, wirkt sie. Das ist messbar, ohne dass ihr eine Kennzahl einführen müsst.
Wie lässt sich euer Marketingalltag einfacher machen?
In 30 Minuten schauen wir gemeinsam darauf, wo euch heute unnötige Abstimmungen, manuelle Aufgaben, Toolwechsel oder wiederkehrende Content-Arbeit Zeit kosten.
Du bekommst eine konkrete Einordnung, welche Aufgaben ihr vereinfachen, automatisieren oder besser organisieren könnt und wo KI und Tools tatsächlich helfen, statt zusätzliche Komplexität zu schaffen.
Alles an eurem tatsächlichen Marketingalltag.
30 Minuten, um deinen Marketingalltag zu vereinfachen Kostenfrei. Du nimmst konkrete Ansatzpunkte mit, die ihr intern direkt weiterverwenden könnt.
Dennis Gumprich
Dennis begleitet Marketing- und Kommunikationsteams bei der Frage, wie generative KI in bestehende Content-Prozesse passt, ohne Qualität, Markensprache und Freigaben zu untergraben. Schwerpunkte: Content Operations, AI Governance und Toolauswahl in Mittelstand und Konzern.
Transparenzhinweis: Dennis arbeitet für contentbird, einen Anbieter von KI-gestützter Content-Software. Produkterwähnungen sind im Beitrag gekennzeichnet. Mehr über Dennis · LinkedIn
Weiterlesen
Entstehung dieses Beitrags
Dieser Beitrag ist unter Einsatz von KI entstanden. Struktur, Recherche und Formulierungsentwürfe wurden KI-gestützt erarbeitet. Fachliche Einordnung, Prüfung der Aussagen und die finale Fassung liegen bei Dennis Gumprich.
Zur Belastbarkeit der Aussagen
Die Bereichseinteilung, die Pflegeintervalle und die Aufwandsangaben sind ausdrücklich als Arbeitsmodelle gekennzeichnet und kein Branchenstandard.
Rechtlicher Hinweis
Dieser Beitrag ersetzt keine Rechts- oder Datenschutzberatung. Welche Inhalte ihr in einer Wissensbasis verarbeiten dürft, insbesondere bei Nutzung externer Dienste, klärt eure Datenschutzstelle.