Der Agent hat über das Wochenende gearbeitet. Im Postfach liegen zwölf Themenvorschläge mit Begründung, ein Abgleich mit den Veröffentlichungen von drei Wettbewerbern und drei fertige LinkedIn-Entwürfe zum Fachartikel der letzten Woche. Das hätte das Team sonst zwei Tage gekostet.
Beim Lesen fällt auf: Neun der zwölf Vorschläge sind brauchbar, zwei davon richtig gut. Einer stützt sich auf eine Studie, die es nicht gibt. Und einer der LinkedIn-Entwürfe klingt nach der Schwestermarke, nicht nach euch. Die Frage am Kaffeeautomaten lautet nicht mehr, ob Agenten etwas taugen. Sie lautet, was man ihnen überlassen kann und was nicht.
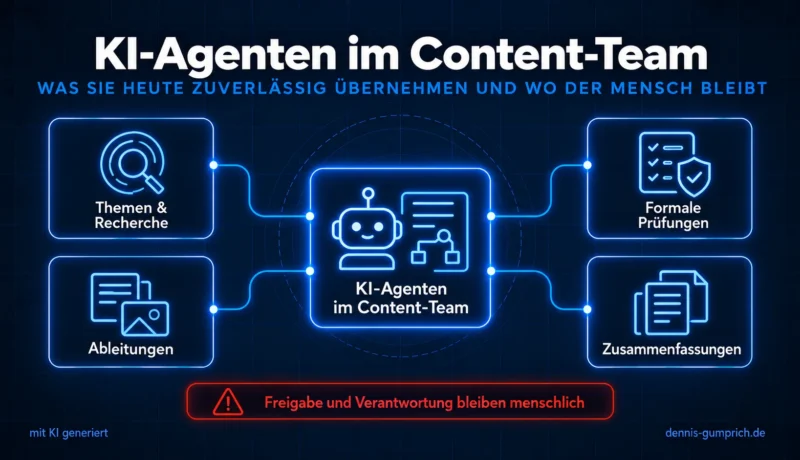
Ein KI-Agent arbeitet eine Kette von Aufgaben eigenständig ab, statt auf einzelne Anweisungen zu antworten. Im Content-Alltag übernehmen Agenten heute zuverlässig Recherche, Ableitungen aus freigegebenen Inhalten, formale Prüfungen und Zusammenfassungen. Unzuverlässig sind sie bei Belegen, bei feinen Tonalitätsunterschieden und überall dort, wo Wissen fehlt, das nirgends aufgeschrieben ist. Entscheidung, Freigabe und Verantwortung bleiben beim Menschen. Der Erfolg hängt weniger am Modell als an Kontext, Rechten und Prüfpunkten.
Was unterscheidet einen KI-Agenten von einem Chat mit KI?
Im Chat gibt ein Mensch jeden Schritt vor und bewertet jede Antwort. Ein Agent bekommt ein Ziel, plant die Schritte selbst, nutzt dabei Werkzeuge wie Suche, Dateien oder ein CMS, prüft Zwischenergebnisse und liefert am Ende ein Ergebnis. Der Mensch steuert nicht mehr jeden Schritt, sondern Auftrag und Abnahme.
Der Begriff wird inzwischen für fast alles verwendet, was mit KI zu tun hat. Das macht Gespräche darüber schwierig, weil jeder etwas anderes meint. Eine praktische Abgrenzung hilft: Entscheidend ist, wer über den nächsten Schritt entscheidet. Wenn das nach jeder Antwort ein Mensch tut, ist es ein Chat, auch wenn er sehr gut ist. Wenn das System selbst entscheidet, welcher Schritt als Nächstes nötig ist, und dafür Werkzeuge einsetzt, ist es ein Agent.
| Chat | Assistent mit Vorlagen | Agent | |
|---|---|---|---|
| Wer plant die Schritte | der Mensch | die Vorlage | der Agent |
| Werkzeuge | keine oder wenige | fest definierte | wählt selbst aus den freigegebenen |
| Kontext | was im Prompt steht | hinterlegte Vorgaben | Wissensbasis, Systeme, bisherige Ergebnisse |
| Rolle des Menschen | steuert jeden Schritt | startet und prüft | beauftragt, prüft an festen Punkten, nimmt ab |
| Typisches Beispiel | Formuliere diesen Absatz um | Erstelle einen LinkedIn-Post nach Vorlage | Leite aus dem freigegebenen Artikel alle Kanalfassungen ab und lege sie zur Freigabe an |
Die mittlere Stufe wird oft übersehen und ist für viele Teams der eigentliche Gewinn. Wer feste Vorlagen mit hinterlegter Markensprache nutzt, bekommt einen Großteil des Nutzens bei deutlich weniger Risiko. Agenten lohnen sich dort, wo die Aufgabe aus mehreren Schritten besteht, die heute ein Mensch von Hand verkettet.
Warum Agenten gerade jetzt im Marketing ankommen
Drei Entwicklungen sind zusammengekommen. Die Modelle sind bei mehrstufigen Aufgaben deutlich verlässlicher geworden, sie verlieren das Ziel seltener aus den Augen und erkennen häufiger, wenn ein Zwischenergebnis nicht passt. Mit dem Model Context Protocol gibt es einen verbreiteten Standard, über den Agenten auf Werkzeuge zugreifen können, vom Dateiablage-System bis zum CMS. Und die Anbieter von Content-Software bauen Agenten direkt in ihre Werkzeuge ein, sodass sie dort arbeiten, wo die Inhalte ohnehin entstehen.
Gleichzeitig ist eine Lücke entstanden zwischen dem, was in Vorführungen gezeigt wird, und dem, was im Alltag trägt. Eine Vorführung zeigt einen Agenten, der aus einem Satz eine komplette Kampagne baut. Der Alltag zeigt, dass diese Kampagne ohne Kontext aus dem Unternehmen generisch bleibt, an zwei Stellen fachlich falsch ist und von der Rechtsabteilung zurückkommt. Beides ist wahr. Die Aufgabe besteht darin, die Teile zu finden, in denen Agenten heute schon zuverlässig Zeit sparen, und sie dort einzusetzen.
Welche Aufgaben übernehmen KI-Agenten heute zuverlässig?
Aufgaben mit klarem Eingang, klarem Ergebnis und überprüfbarer Qualität: Recherche und Themenvorschläge, Ableitungen aus bereits freigegebenen Inhalten, formale Prüfungen gegen festgelegte Regeln, Zusammenfassungen von Gesprächen und Dokumenten sowie wiederkehrende Auswertungen. Je weniger implizites Wissen eine Aufgabe braucht, desto besser eignet sie sich.
Die folgende Einordnung ist ein Arbeitsmodell aus der Praxis. Sie beschreibt den Stand im Herbst 2026 und wird sich verschieben. Die Grundlogik dahinter wird bleiben: Agenten sind stark, wo Regeln explizit sind, und schwach, wo sie nur in Köpfen existieren.
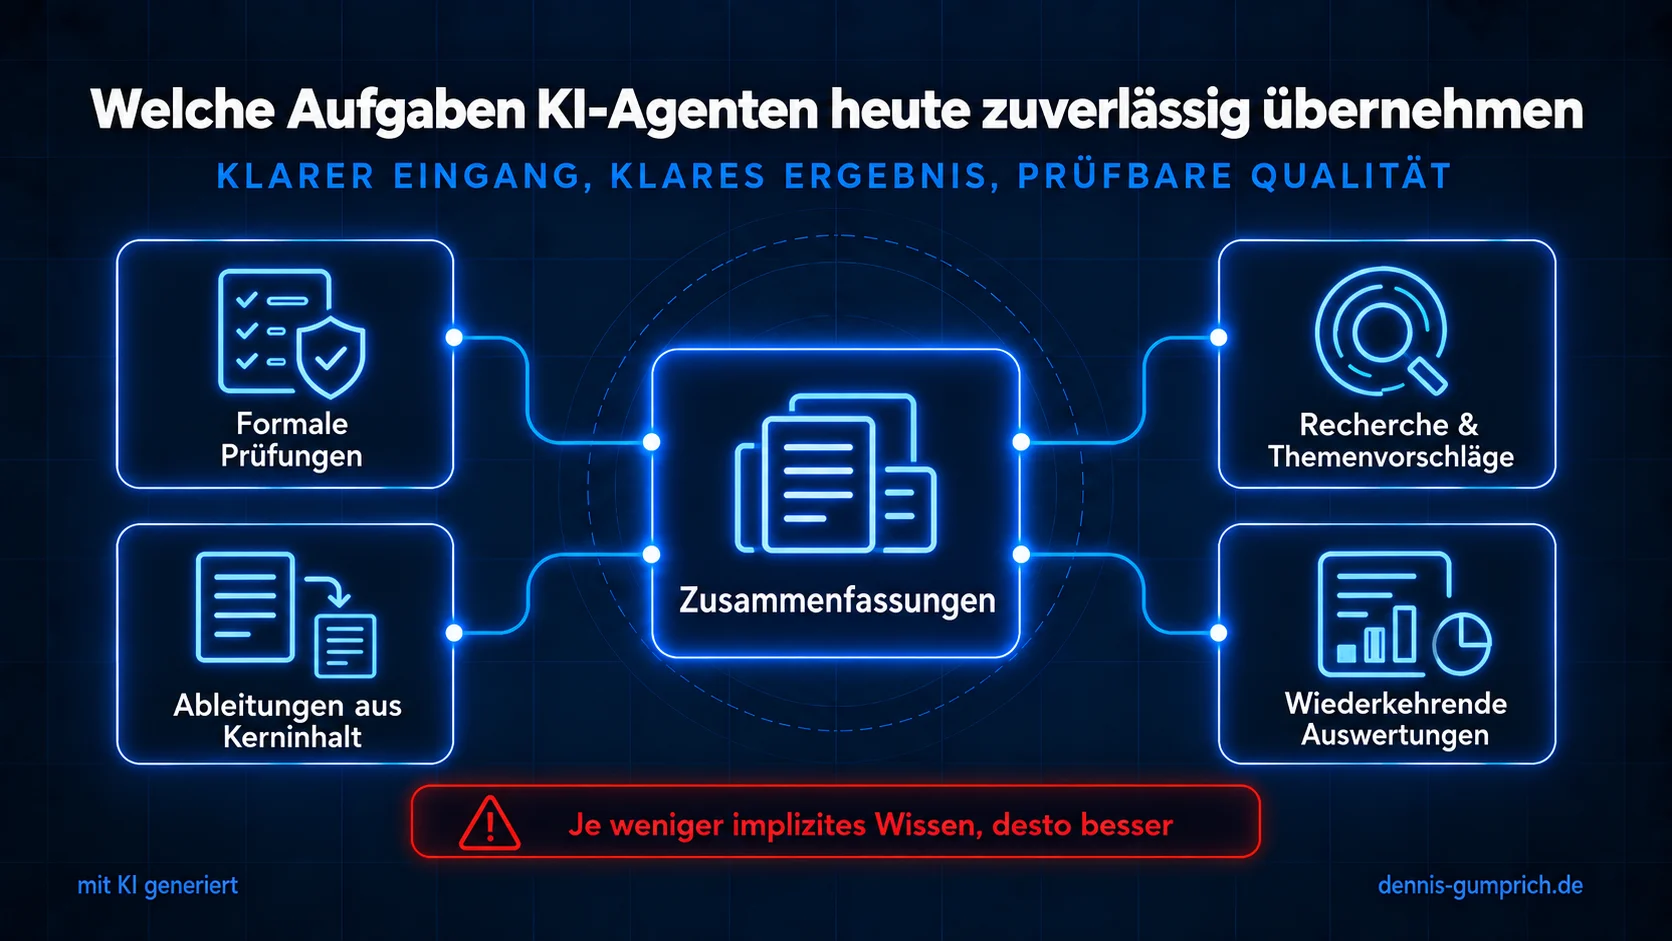
| Aufgabe | Eignung | Menschlicher Anteil |
|---|---|---|
| Formale Prüfung gegen Regeln (Länge, Struktur, Metadaten, Begriffe) | sehr hoch | Regeln festlegen, Ausnahmen entscheiden |
| Ableitungen aus freigegebenem Kerninhalt | hoch | formale Prüfung je Kanal |
| Zusammenfassung von Gesprächen und Dokumenten | hoch | Stichprobe, Gewichtung prüfen |
| Recherche und Themenvorschläge | hoch | Belege prüfen, auswählen |
| Wiederkehrende Auswertungen und Berichte | hoch | Interpretation |
| Erstfassung einer Übersetzung oder Lokalisierung | mittel bis hoch | Fachbegriffe und lokale Besonderheiten prüfen |
| Erstentwurf eines Fachtextes | mittel | Substanz, Belege, Haltung ergänzen |
| Themenauswahl und Priorisierung | niedrig | Entscheidung bleibt beim Team |
| Freigabe und Veröffentlichung | nicht delegieren | vollständig menschlich |
| Kommunikation in Krisen und heiklen Lagen | nicht delegieren | vollständig menschlich |
Auffällig ist die Zeile zu Ableitungen. Sie gehört zu den wirtschaftlich interessantesten Einsatzfeldern, weil der Ausgangsinhalt bereits fachlich geprüft ist. Der Agent erfindet nichts Neues, sondern überträgt Geprüftes in andere Formate. Das Risiko ist entsprechend kleiner, und der Zeitgewinn ist groß, weil gerade die Ableitungen in vielen Teams am meisten Handarbeit kosten.
Wo scheitern KI-Agenten im Content-Alltag?
An fünf Stellen: Sie erfinden Belege, sie verwechseln Tonalitäten zwischen Marken, ihnen fehlt Wissen, das nur in Köpfen existiert, Fehler pflanzen sich in Ketten fort, und bei unklaren Aufträgen liefern sie plausible, aber falsche Ergebnisse. Alle fünf lassen sich eingrenzen, keiner verschwindet ganz.
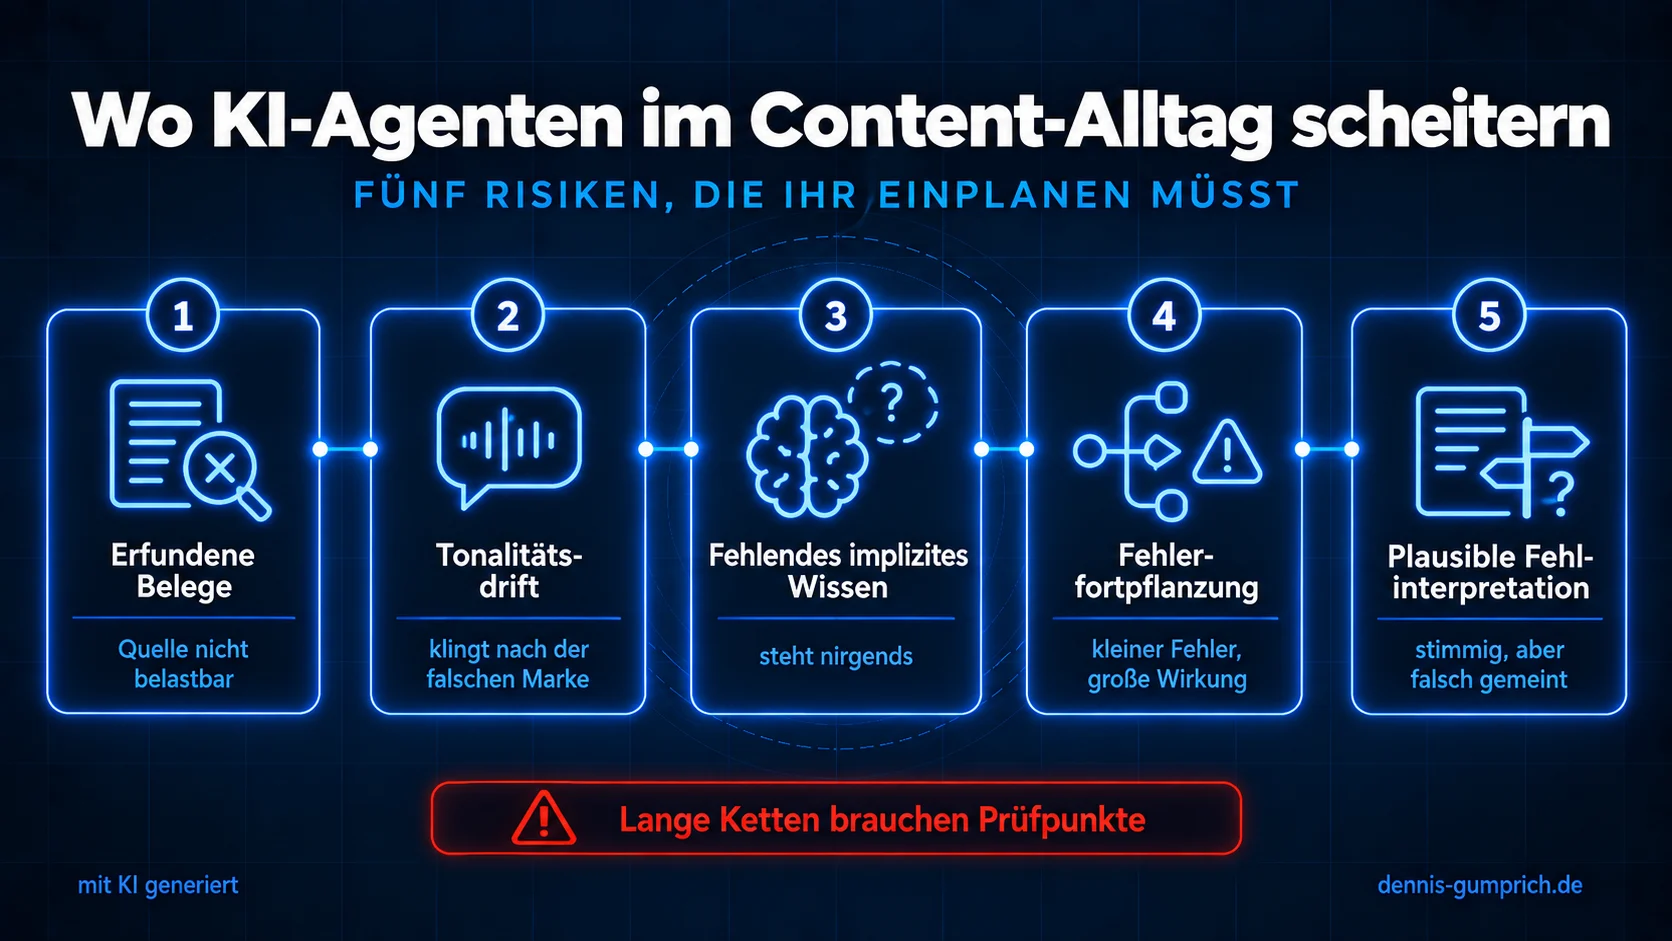
- Erfundene BelegeEin Agent, der eine Aussage stützen soll, findet manchmal eine Quelle, die es nicht gibt, oder schreibt einer echten Quelle eine falsche Zahl zu. Das ist bei mehrstufiger Recherche häufiger als im Chat, weil niemand jeden Zwischenschritt liest. Wie ihr solche Fehler systematisch abfangt, steht im Beitrag zu Halluzinationen im Marketing-Text.
- TonalitätsdriftBei mehreren Marken oder Absendern vermischen Agenten Stile, sobald der Kontext nicht sauber getrennt ist. Das Ergebnis klingt dann richtig, aber nach dem falschen Absender.
- Fehlendes implizites WissenDass ein bestimmtes Thema gerade intern heikel ist, dass ein Kunde nicht mehr genannt werden darf, dass die Geschäftsführung ein Wort nicht mag: Was nirgends steht, kann ein Agent nicht wissen.
- FehlerfortpflanzungEin kleiner Fehler im ersten Schritt wird in jedem weiteren Schritt verstärkt. Am Ende steht ein überzeugend aussehendes Ergebnis auf falscher Grundlage.
- Plausible FehlinterpretationIst der Auftrag mehrdeutig, entscheidet sich der Agent für eine Lesart und führt sie konsequent aus. Das Ergebnis ist in sich stimmig und trotzdem nicht das, was gemeint war.
Warum Ketten anders scheitern als einzelne Schritte
Der vierte Punkt verdient einen eigenen Abschnitt, weil er den wichtigsten Unterschied zwischen Chat und Agent erklärt. Im Chat sieht ein Mensch jedes Zwischenergebnis und korrigiert sofort. Beim Agenten entfallen diese Korrekturen, und kleine Fehlerquoten addieren sich.
Eine einfache Rechnung zeigt das. Angenommen, ein Agent erledigt jeden einzelnen Schritt in 95 von 100 Fällen korrekt. Das klingt nach einer hohen Quote. Besteht die Aufgabe aus fünf aufeinander aufbauenden Schritten, liegt die Wahrscheinlichkeit, dass alle fünf korrekt sind, nur noch bei etwa 77 Prozent. Bei zehn Schritten sind es rund 60 Prozent. Jedes vierte bis zweite Ergebnis enthält dann irgendwo einen Fehler, und zwar nicht unbedingt an einer Stelle, die beim Überfliegen auffällt.
Die Konsequenz ist nicht, auf Agenten zu verzichten. Die Konsequenz ist, Ketten kurz zu halten und Prüfpunkte an die Stellen zu setzen, an denen ein Fehler am teuersten wäre. Ein Agent, der nach der Recherche anhält und die Quellen zur Prüfung vorlegt, bevor er schreibt, ist langsamer als einer, der durchläuft. Er ist aber deutlich verlässlicher, und die Prüfung kostet Minuten statt Stunden.
Wie sieht ein gut gebauter Content-Agent aus?
Er hat sechs Bestandteile: einen eindeutigen Auftrag, Zugriff auf den richtigen Kontext, Werkzeuge mit begrenzten Rechten, feste Prüfpunkte für Menschen, ein nachvollziehbares Protokoll und klare Kriterien, wann er abbricht und nachfragt.
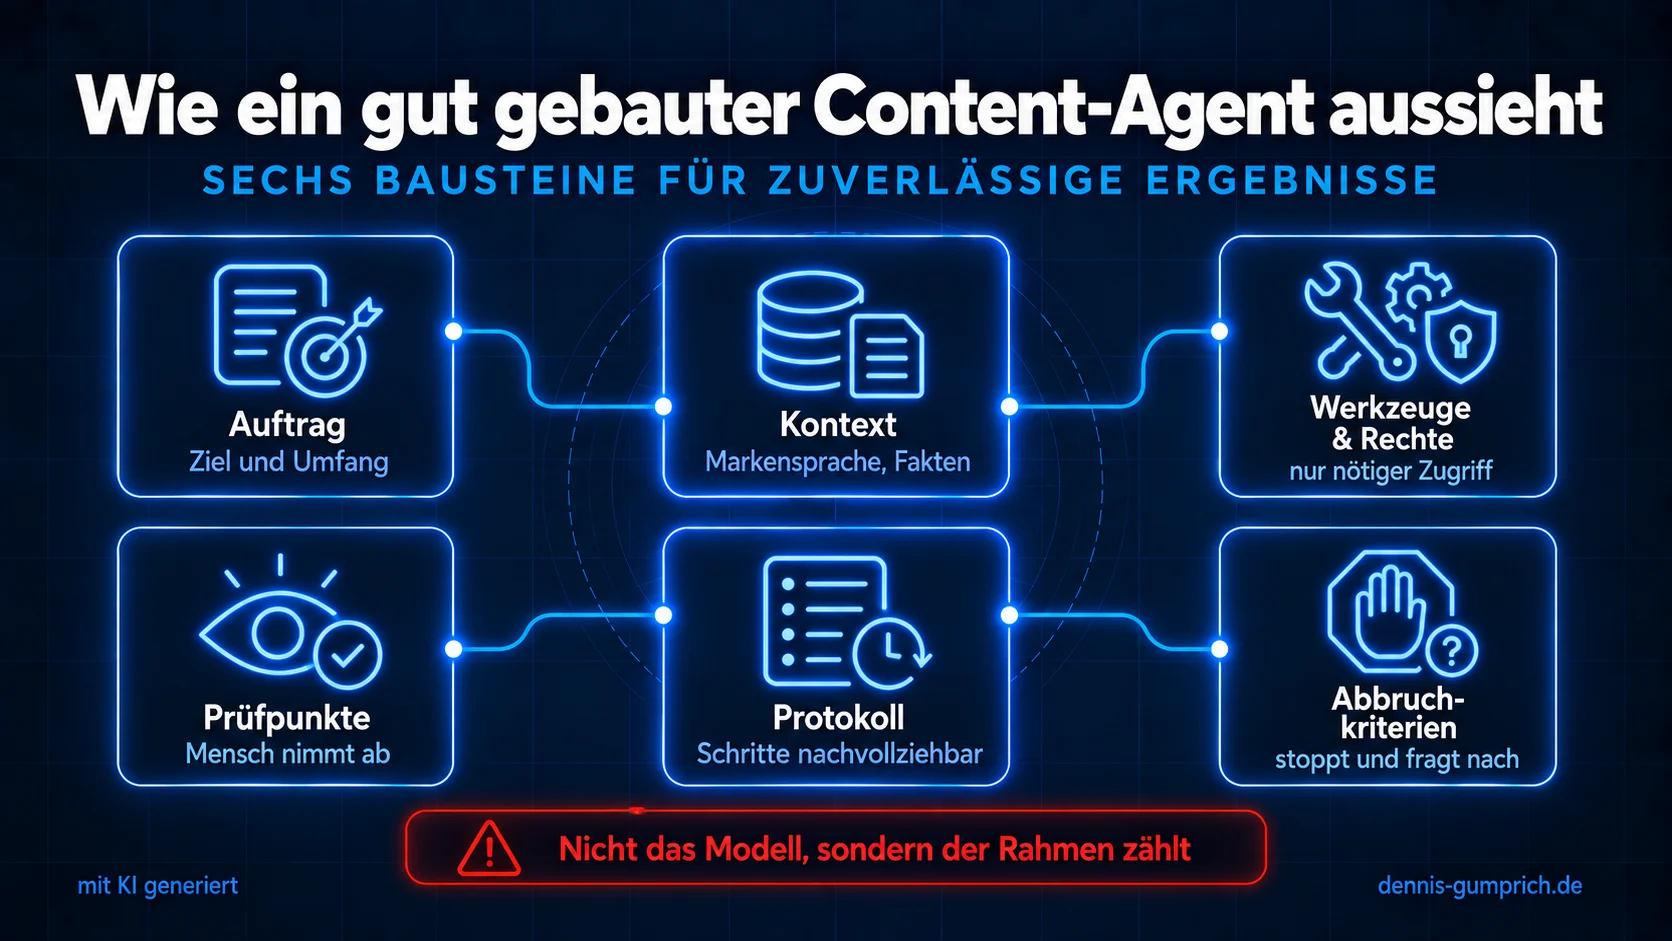
| Bestandteil | Was er regelt | Typischer Fehler, wenn er fehlt |
|---|---|---|
| Auftrag | Ziel, Ergebnis, Umfang, was nicht zu tun ist | plausible, aber falsche Lesart |
| Kontext | Markensprache, Wissensbasis, gesicherte Fakten, Zielgruppe | generische Ergebnisse, falsche Tonalität |
| Werkzeuge und Rechte | worauf er zugreifen und was er verändern darf | unerwünschte Änderungen in Systemen |
| Prüfpunkte | wo ein Mensch Zwischenergebnisse abnimmt | Fehlerfortpflanzung über die Kette |
| Protokoll | welche Schritte, Quellen und Entscheidungen es gab | Ergebnis nicht nachvollziehbar |
| Abbruchkriterien | wann er stoppt und nachfragt | Weiterarbeiten auf falscher Grundlage |
Der wichtigste Bestandteil ist der Kontext. Ein Agent ohne Zugriff auf eure Markensprache, eure gesicherten Fakten und eure bisherigen Inhalte produziert Texte, die nach jedem Unternehmen klingen. Mit diesem Zugriff produziert er Texte, die nach euch klingen und sich auf eure Aussagen stützen. Wie ihr diesen Kontext aufbaut, steht in den Beiträgen zur Wissensbasis und zur hinterlegten Markensprache. Wer diese Grundlage nicht hat, sollte dort anfangen und nicht beim Agenten.
Fünf Content-Agenten, die sich im Alltag bewähren
Die folgenden Beispiele sind bewusst unspektakulär. Sie beschreiben Agenten, die eine wiederkehrende Aufgabe übernehmen und an einer klar definierten Stelle an Menschen übergeben. Genau diese Art von Agenten trägt im Alltag.
- Agent 1Der ThemenradarBeobachtet festgelegte Quellen, Wettbewerber und Fragen aus dem Vertrieb, schlägt wöchentlich Themen mit Begründung und Quellen vor. Prüfpunkt: Die Redaktion prüft die Quellen und entscheidet in der Themenkonferenz. Wie ihr Themen dabei vergleichbar macht, steht im Beitrag zum Themenscoring.
- Agent 2Der AbleiterNimmt einen freigegebenen Kerninhalt und erstellt daraus die Fassungen für LinkedIn, Newsletter, Intranet und Kurzmeldung, jeweils nach Kanalregeln. Prüfpunkt: formale Freigabe je Kanal, keine erneute Fachfreigabe.
- Agent 3Der PrüferPrüft jeden Entwurf vor der Freigabe gegen Markensprache, Begriffsregeln, Struktur, Zitierfähigkeit und rechtliche Prüfregeln, etwa zu Umweltaussagen. Prüfpunkt: Die Autorin entscheidet, welche Hinweise sie übernimmt.
- Agent 4Vom Gespräch zum EntwurfErstellt aus dem Transkript eines Fachgesprächs mit einer Expertin einen strukturierten Entwurf mit Zitaten und offenen Fragen. Prüfpunkt: Die Expertin prüft ihre Aussagen, die Redaktion den Text.
- Agent 5Der AktualisiererDurchsucht den Bestand regelmäßig nach veralteten Zahlen, toten Links und Aussagen, die neueren Inhalten widersprechen, und legt Änderungsvorschläge an. Prüfpunkt: Die Redaktion entscheidet über jede Änderung.
Allen fünf ist gemeinsam, dass ihr Ergebnis ein Vorschlag ist und keine Veröffentlichung. Der Agent spart die Vorarbeit, der Mensch trifft die Entscheidung. Das ist kein Mangel an Vertrauen in die Technik, sondern eine bewusste Verteilung von Verantwortung, die auch dann noch trägt, wenn die Modelle besser werden.
Welche Rolle bleibt beim Menschen?
Fünf Aufgaben bleiben menschlich: entscheiden, worüber ihr sprecht, verantworten, was veröffentlicht wird, Kontext liefern, der nirgends aufgeschrieben ist, urteilen in heiklen Situationen und Beziehungen zu Fachabteilungen und Expertinnen pflegen. Die Arbeit verschiebt sich vom Produzieren zum Steuern und Prüfen.
Diese Verschiebung wird in vielen Teams mit Sorge betrachtet, und die Sorge ist nicht unbegründet. Wer bisher vor allem Texte geschrieben hat, wird künftig mehr Texte prüfen, Aufträge formulieren und Kontext pflegen. Das ist eine andere Tätigkeit, und nicht jede Person möchte sie ausüben.
Gleichzeitig wird eine Fähigkeit wertvoller, die bisher wenig sichtbar war: die Urteilskraft darüber, ob ein Text gut ist. Wer schnell erkennt, dass ein Absatz zwar korrekt, aber für diese Zielgruppe falsch gewichtet ist, wer merkt, dass eine Formulierung in der aktuellen Lage missverstanden werden könnte, wer weiß, welche Expertin man für ein Thema anrufen muss, hat in einem Team mit Agenten mehr Einfluss als vorher, nicht weniger.
Für Führungskräfte bedeutet das, Rollen neu zu beschreiben, bevor die Agenten kommen, und nicht danach. Welche Rollen ein Content-Team grundsätzlich braucht und wie sie sich mit wachsender Automatisierung verändern, steht im Beitrag zu den vier Rollen im Content-Team.
Wie führt ihr den ersten Agenten ein?
Mit einer einzigen, wiederkehrenden und gut beschreibbaren Aufgabe, einem klaren Prüfpunkt und vier Wochen Parallelbetrieb. Gemessen werden eingesparte Zeit und Korrekturquote. Erst wenn beide Werte überzeugen, kommt der zweite Agent.
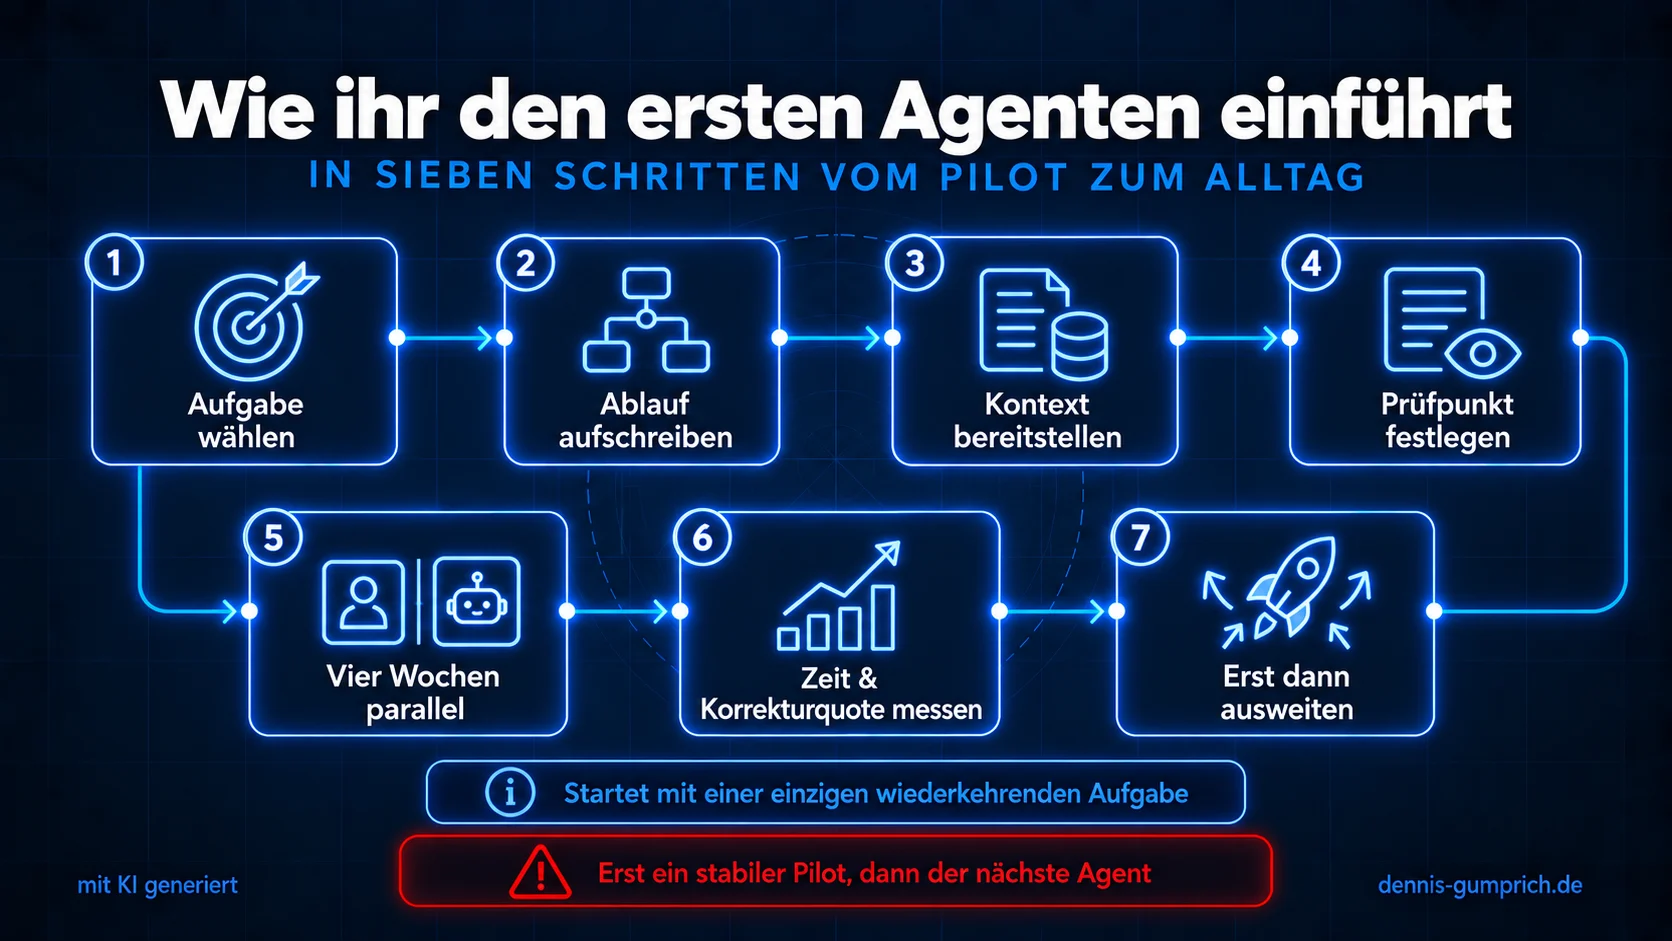
- Schritt 1Aufgabe wählenEine Aufgabe, die mindestens wöchentlich anfällt, aus mehreren Schritten besteht und deren Ergebnis sich gut prüfen lässt. Ableitungen und formale Prüfungen sind fast immer gute Kandidaten.
- Schritt 2Heutigen Ablauf aufschreibenWelche Schritte macht ein Mensch heute, in welcher Reihenfolge, mit welchen Quellen, nach welchen Regeln? Diese Beschreibung ist der Auftrag für den Agenten und deckt nebenbei auf, wie viele Regeln bisher nur im Kopf existierten.
- Schritt 3Kontext bereitstellenMarkensprache, Beispiele guter Ergebnisse, gesicherte Fakten. Ohne diese Grundlage beurteilt ihr nicht den Agenten, sondern das Fehlen eures Kontexts.
- Schritt 4Prüfpunkt festlegenWo nimmt ein Mensch ab, und nach welchen Kriterien? Schreibt die Kriterien auf, damit die Abnahme nicht von der Tagesform abhängt.
- Schritt 5Vier Wochen parallelDer Agent arbeitet, der bisherige Ablauf läuft weiter. So seht ihr, wo Ergebnisse abweichen, ohne dass etwas Unfertiges veröffentlicht wird.
- Schritt 6Zwei Zahlen messenEingesparte Zeit je Durchlauf und Anteil der Ergebnisse, die nachgebessert werden mussten. Beide Zahlen gehören zusammen, weil eine Zeitersparnis bei hoher Korrekturquote keine ist.
- Schritt 7Erst dann ausweitenDer zweite Agent kommt, wenn der erste stabil läuft. Wer mit fünf Agenten gleichzeitig startet, kann am Ende nicht sagen, welcher wofür verantwortlich ist.
Diese Reihenfolge entspricht dem, was für jede Einführung gilt: Ein kurzer Test beweist wenig, ein strukturierter Pilot mit klaren Kriterien sehr viel. Mehr dazu im Beitrag Pilot und Rollout.
Governance: Rechte, Protokoll und Kennzeichnung
Sobald ein Agent nicht nur Texte vorschlägt, sondern in Systemen handelt, werden drei Fragen wichtig, die beim Chat kaum eine Rolle spielten.
Rechte. Ein Agent bekommt nur die Rechte, die er für seine Aufgabe braucht. Ein Ableiter muss Entwürfe anlegen können, aber nichts veröffentlichen. Ein Prüfer muss lesen und kommentieren können, aber nichts ändern. Diese Trennung ist in den meisten Systemen über Rollen abbildbar und sollte von Anfang an so eingerichtet sein.
Protokoll. Jede Aktion eines Agenten muss nachvollziehbar sein: welche Quellen er genutzt, welche Entscheidungen er getroffen, welche Inhalte er verändert hat. Das ist nicht nur für die IT wichtig, sondern für die Redaktion selbst. Wer ein fehlerhaftes Ergebnis findet, muss sehen können, an welchem Schritt es entstanden ist.
Kennzeichnung. Ob und wie ihr KI-Beteiligung gegenüber Lesern kennzeichnet, ist eine eigene Entscheidung, die ihr einmal grundsätzlich treffen solltet, statt sie je Inhalt neu zu diskutieren. Wie ihr diese Praxis festlegt, steht im Beitrag zur KI-Kennzeichnung.
In eigener Sache
Ich arbeite für contentbird. Dort lassen sich Agenten für wiederkehrende Content-Aufgaben einrichten, etwa für Ableitungen, Recherche oder Prüfungen. Sie arbeiten mit der hinterlegten Markensprache und Wissensbasis und geben ihre Ergebnisse in den bestehenden Workflow mit Freigabe, statt selbst zu veröffentlichen. Die Erfahrung aus Pilotprojekten deckt sich mit diesem Beitrag: Wenn ein Agent schlechte Ergebnisse liefert, liegt es meist nicht am Agenten, sondern am fehlenden Kontext oder an einem zu offen formulierten Auftrag.
Fünf Fehler bei der Einführung von KI-Agenten
- Mit dem größten Use Case startenDie komplette Kampagne auf Knopfdruck ist das eindrucksvollste Beispiel und der schlechteste Einstieg. Startet mit einer kleinen, häufigen Aufgabe.
- Kontext überspringenOhne Markensprache und gesicherte Fakten bewertet ihr nicht den Agenten, sondern das Fehlen eurer Grundlagen.
- Lange Ketten ohne PrüfpunktJe mehr Schritte ohne menschlichen Blick, desto höher die Wahrscheinlichkeit, dass irgendwo ein Fehler steckt.
- Veröffentlichungsrechte vergebenEin Agent, der selbst veröffentlichen darf, spart wenige Minuten und erzeugt ein Risiko, das in keinem Verhältnis dazu steht.
- Nur die Zeit messenWer nur die eingesparte Zeit misst, übersieht die Nacharbeit. Messt Zeit und Korrekturquote gemeinsam.
Wann sind Agenten für euch noch nicht sinnvoll?
Wenn eure Abläufe nicht beschrieben sind, wenn es keine hinterlegte Markensprache und keine gesicherten Fakten gibt oder wenn eure Inhalte überwiegend Einzelstücke ohne wiederkehrendes Muster sind. In diesen Fällen bringt die Arbeit an den Grundlagen mehr als ein Agent.
Ein Agent automatisiert einen Ablauf. Wenn dieser Ablauf nicht existiert, sondern jedes Mal neu entsteht, gibt es nichts zu automatisieren. Das ist keine Schwäche des Teams, viele kreative Aufgaben sind genau so. Aber es bedeutet, dass der Nutzen von Agenten dort kleiner ist als in Teams mit vielen wiederkehrenden Formaten und Kanälen.
Der vielleicht wichtigste Nebeneffekt einer Agenten-Einführung ist deshalb, dass sie zur Beschreibung der eigenen Arbeit zwingt. Teams, die für einen Agenten zum ersten Mal aufschreiben, wie eine Ableitung entsteht und nach welchen Regeln sie geprüft wird, profitieren davon auch ohne Agenten: in der Einarbeitung neuer Kolleginnen, in der Vertretung bei Urlaub, in der Abstimmung mit Agenturen.
Selbstcheck: Seid ihr bereit für den ersten Agenten?
Setzt Haken bei allem, was auf euch zutrifft.
kurze Einordnung zu KI-Agenten im Content-Team:
KI-Agenten arbeiten Aufgabenketten selbstständig ab, statt auf einzelne Anweisungen zu antworten. Im Content-Alltag sind sie heute zuverlässig bei Recherche, Ableitungen aus freigegebenen Inhalten, formalen Prüfungen und Zusammenfassungen. Unzuverlässig sind sie bei Belegen, feinen Tonalitätsunterschieden und überall dort, wo Wissen nicht aufgeschrieben ist.
Entscheidend für den Erfolg sind nicht die Modelle, sondern drei Dinge auf unserer Seite: hinterlegter Kontext wie Markensprache und gesicherte Fakten, klar begrenzte Rechte und feste Prüfpunkte. Veröffentlicht wird weiterhin von uns.
Vorschlag: Wir wählen eine einzige wiederkehrende Aufgabe, zum Beispiel die Ableitung von Kanalfassungen aus freigegebenen Artikeln, und testen einen Agenten vier Wochen parallel zum bisherigen Ablauf. Gemessen werden eingesparte Zeit und Korrekturquote.
Fazit: Agenten verschieben die Arbeit, sie nehmen sie nicht ab
KI-Agenten sind im Content-Alltag angekommen, und sie sparen dort spürbar Zeit, wo Aufgaben wiederkehrend, beschreibbar und prüfbar sind. Sie sind nicht die autonomen Kampagnenmaschinen aus den Vorführungen, und sie werden es so bald auch nicht sein, weil ihnen das Wissen fehlt, das in keiner Datei steht.
Wer sie erfolgreich einsetzen will, investiert deshalb zuerst in das, was ein Agent braucht: aufgeschriebene Abläufe, hinterlegte Markensprache, gesicherte Fakten, klare Rechte und feste Prüfpunkte. Das ist weniger aufregend als ein neues Werkzeug. Es ist aber der Teil, der über den Nutzen entscheidet, und er macht das Team auch dann besser, wenn gerade kein Agent läuft.
Häufige Fragen
Ersetzen KI-Agenten Stellen im Content-Team?
Sie verändern Tätigkeiten stärker als Stellen. Vorarbeit, Ableitungen und formale Prüfungen gehen zurück, Steuerung, Prüfung und Kontextpflege nehmen zu. Teams, die ihre Rollen frühzeitig neu beschreiben, nutzen die gewonnene Zeit für Themen, die bisher liegen geblieben sind.
Welche Aufgabe eignet sich am besten für den Einstieg?
Meist die Ableitung von Kanalfassungen aus bereits freigegebenen Inhalten oder eine formale Prüfung vor der Freigabe. Beide fallen häufig an, beruhen auf geprüftem Material und lassen sich gut bewerten. Recherche ist ebenfalls geeignet, braucht aber einen Prüfpunkt für die Quellen.
Wie verhindern wir, dass ein Agent falsche Fakten verbreitet?
Durch drei Maßnahmen: eine Sammlung gesicherter Fakten, auf die der Agent zugreift, einen Prüfpunkt für Quellen bei jeder Recherche und das Prinzip, dass der Agent keine Inhalte veröffentlicht. Ganz ausschließen lassen sich Fehler nicht, sie werden aber gefunden, bevor sie öffentlich werden.
Brauchen wir dafür eigene Entwicklerinnen oder Entwickler?
Für Agenten innerhalb von Content-Software in der Regel nicht, sie werden dort über Aufträge, Vorlagen und Rechte konfiguriert. Eigene Entwicklung wird nötig, wenn ein Agent über viele interne Systeme hinweg arbeiten soll, die keine passende Anbindung haben.
Was ist mit Datenschutz, wenn Agenten auf interne Daten zugreifen?
Es gelten dieselben Fragen wie bei jedem KI-Einsatz: wo die Daten verarbeitet werden, ob sie zum Training genutzt werden und wer Zugriff hat. Hinzu kommt die Frage, auf welche Systeme der Agent zugreifen darf. Klärt das vor dem Pilot mit IT und Datenschutz, wie im Beitrag IT und Datenschutz früh einbinden beschrieben.
Woran erkennen wir, dass ein Agent gut funktioniert?
An zwei Zahlen über mindestens vier Wochen: eingesparte Zeit je Durchlauf und Anteil der Ergebnisse, die nachgebessert werden mussten. Wenn die Zeitersparnis deutlich ist und die Korrekturquote sinkt, läuft der Agent gut. Wenn die Korrekturquote hoch bleibt, liegt das Problem meist am Kontext oder am Auftrag.
Wie lässt sich euer Marketingalltag einfacher machen?
In 30 Minuten schauen wir gemeinsam darauf, wo euch heute unnötige Abstimmungen, manuelle Aufgaben, Toolwechsel oder wiederkehrende Content-Arbeit Zeit kosten.
Wenn ihr über den Einsatz von KI-Agenten nachdenkt, suchen wir gemeinsam die eine wiederkehrende Aufgabe, mit der sich ein Einstieg lohnt, und klären, welcher Kontext dafür vorliegen muss.
Alles an eurem tatsächlichen Marketingalltag.
30 Minuten, um deinen Marketingalltag zu vereinfachen Kostenfrei. Du nimmst konkrete Ansatzpunkte mit, die ihr intern direkt weiterverwenden könnt.
Dennis Gumprich
Dennis begleitet Marketing- und Kommunikationsteams bei der Frage, wie generative KI in bestehende Content-Prozesse passt, ohne Qualität, Markensprache und Freigaben zu untergraben. Schwerpunkte: Content Operations, AI Governance und Toolauswahl in Mittelstand und Konzern.
Transparenzhinweis: Dennis arbeitet für contentbird, einen Anbieter von KI-gestützter Content-Software. Produkterwähnungen sind im Beitrag gekennzeichnet. Mehr über Dennis · LinkedIn
Weiterlesen
Entstehung dieses Beitrags
Dieser Beitrag ist unter Einsatz von KI entstanden. Struktur, Recherche und Formulierungsentwürfe wurden KI-gestützt erarbeitet. Fachliche Einordnung, Prüfung der Aussagen und die finale Fassung liegen bei Dennis Gumprich.
Zur Belastbarkeit der Aussagen
Die Eignungstabelle und die Beispiel-Agenten sind Arbeitsmodelle aus Pilotprojekten und Gesprächen mit Content-Teams, Stand Herbst 2026. Die Rechnung zur Fehlerfortpflanzung ist ein vereinfachtes Beispiel und setzt voneinander unabhängige Schritte voraus, sie zeigt eine Größenordnung, keine Messung.