Vor vier Wochen hat euer Team einen Ratgeber veröffentlicht. Die Erstfassung kam aus der KI, die Redaktion hat sie geglättet, die Fachabteilung hat freigegeben. Der Text ist sauber gegliedert, gut lesbar und beantwortet genau die Frage, die eure Kundschaft im Vertrieb immer wieder stellt.
Eine Kollegin stellt diese Frage heute in ChatGPT und in Perplexity. Genannt werden drei andere Anbieter, zitiert werden zwei Fachartikel und ein Leitfaden eines Verbands. Euer Ratgeber taucht nicht auf. Beim Vergleich fällt auf: Alle drei zitierten Quellen haben einen namentlichen Autor, ein konkretes Praxisbeispiel und Zahlen mit Herkunft. Euer Text hat nichts davon.
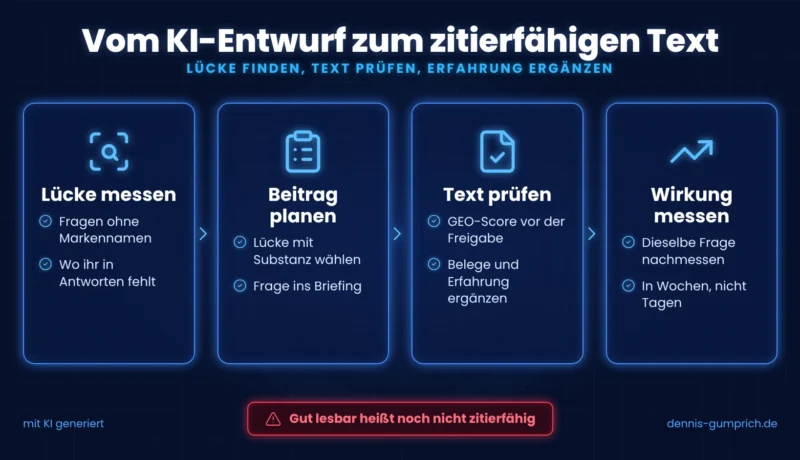
KI-Entwürfe scheitern in ChatGPT, Perplexity und den AI Overviews von Google selten an der Sprache, sondern an den Belegen. Struktur, Lesbarkeit und eine direkte Antwort liefert die KI heute zuverlässig. Erfahrung, eigene Zahlen, Quellen und erkennbare Autorenschaft liefert nur euer Team. Der Weg zum zitierfähigen Text hat vier Schritte: Lücke in den KI-Antworten messen, die passende Lücke für einen Beitrag auswählen, den Text vor der Freigabe mit einem GEO-Score prüfen und nach der Veröffentlichung nachmessen.
Dieser Beitrag beschreibt die Arbeit am einzelnen Text: von der Lücke in den KI-Antworten bis zur Prüfung vor der Freigabe. Was KI-Suchen bei der Auswahl ihrer Quellen grundsätzlich berücksichtigen, steht im Grundlagenbeitrag Sichtbar in ChatGPT, Perplexity und AI Overviews. Wie ihr GEO dauerhaft im Team verankert, steht in GEO im Content-Prozess verankern.
Warum werden KI-Entwürfe so selten zitiert?
Weil ein Sprachmodell zusammenfasst, was es bereits gibt. Es schreibt verständlich, gliedert sauber und beantwortet die Frage. Was es nicht kann: von euren Projekten berichten, eure Zahlen nennen oder eine Quelle angeben, die es nicht kennt. Damit entsteht ein Text, der dasselbe sagt wie zehn andere Seiten zur selben Frage, und genau solche Texte haben in einer KI-Antwort keinen Platz.
In der klassischen Suche kostet ein austauschbarer Text ein paar Positionen. In einer KI-Antwort kommt er gar nicht vor, weil das System aus vielen ähnlichen Quellen nur wenige auswählt. Es greift dann zu den Seiten, die etwas beitragen, das die anderen nicht haben: einen dokumentierten Fall, eine eigene Auswertung, eine klar benannte Fachperson.
Dass genau diese Elemente zählen, stützt die Forschung. Die Studie, die den Begriff Generative Engine Optimization geprägt hat, hat verschiedene Änderungen an Texten getestet und gemessen, wie sichtbar die Texte danach in generativen Antworten waren. Ergänzte Zitate, Statistiken und Quellenangaben erhöhten die Sichtbarkeit um bis zu rund 40 Prozent. Keyword Stuffing verschlechterte das Ergebnis dagegen.1
Klare Gliederung, direkte Antwort, kurze Sätze. Ein hypothetisches Beispiel, keine Quellen, kein Autor, kein Datum. Inhaltlich deckungsgleich mit den Seiten, die bereits zitiert werden.
Dieselbe Gliederung, ergänzt um einen echten Praxisfall, eigene Zahlen mit Zeitraum, verlinkte Primärquellen und eine Autorenzeile mit Rolle und Aktualisierungsdatum. Er sagt etwas, das man nur hier findet.
Wie findet ihr die Fragen, bei denen ihr fehlt?
Mit einem festen Katalog von Fragen, die eure Zielgruppe an KI-Assistenten stellt, und zwar ohne euren Markennamen. Diese Fragen lasst ihr regelmäßig in ChatGPT, Gemini, Perplexity und den AI Overviews beantworten und haltet fest, ob ihr genannt werdet, an welcher Stelle und ob eine eurer Seiten als Quelle verlinkt ist. Sortiert nach Erwähnungen stehen eure Lücken oben.
Der Verzicht auf den Markennamen ist entscheidend. Wer nach eurer Marke fragt, kennt euch bereits, und die Antwort beschreibt euch fast immer. Interessant sind die Fragen von Menschen, die sich gerade erst orientieren: Welche Lösung passt zu uns? Wie gehen andere Teams vor? Worauf muss ich achten? Bei diesen Fragen entsteht die Shortlist, und dort entscheidet sich, ob ihr überhaupt in Betracht gezogen werdet.
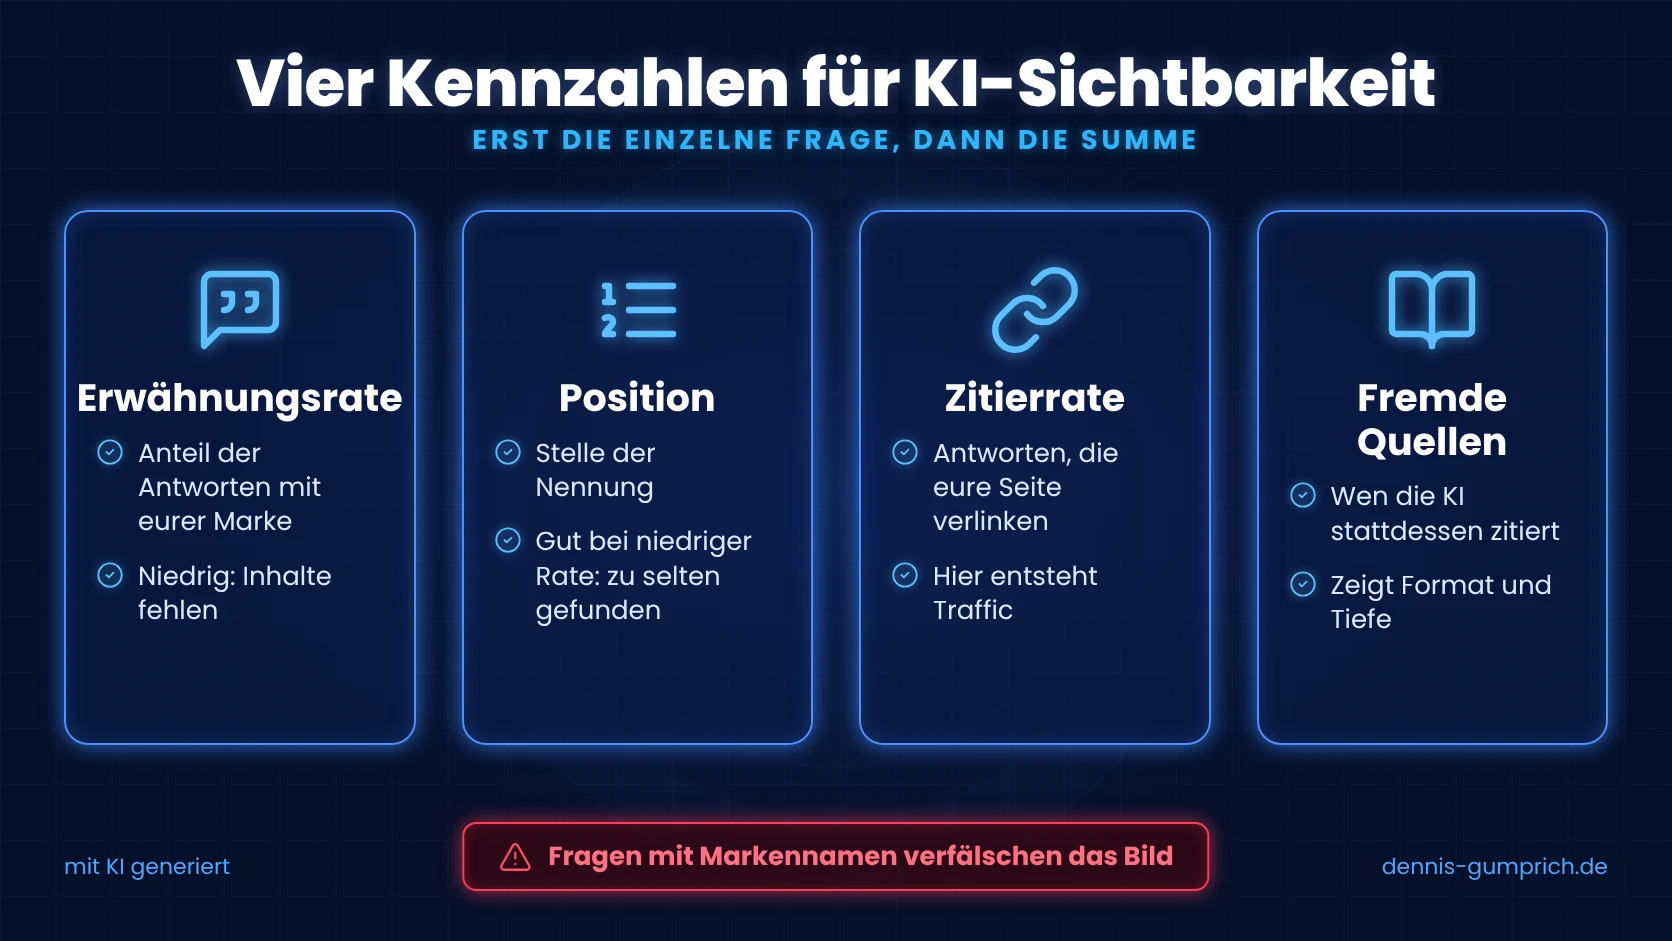
| Kennzahl | Was sie zeigt | Was ihr daraus ableitet |
|---|---|---|
| Erwähnungsrate | Anteil der Antworten, in denen eure Marke vorkommt | niedrig: Zu den Fragen fehlen passende Inhalte, nicht nur Optimierung |
| Durchschnittliche Position | an welcher Stelle ihr genannt werdet, wenn ihr genannt werdet | gut bei niedriger Rate: Ihr werdet geschätzt, aber zu selten gefunden |
| Zitierrate | Anteil der Antworten, die eine eurer Seiten als Quelle verlinken | hier entsteht aus Sichtbarkeit Traffic; niedrig: eure Seiten sind nicht die beste Quelle |
| Fremde Quellen | welche Seiten die KI stattdessen heranzieht | Format, Tiefe und Belegdichte, die ihr mindestens erreichen müsst |
Die Kombination aus Erwähnungsrate und Position ist aufschlussreicher als jede Zahl allein. Eine niedrige Rate bei guter Position heißt: Wenn die KI euch findet, empfiehlt sie euch weit oben. Das Problem ist dann nicht eure Relevanz, sondern die Zahl der Fragen, zu denen ihr eine passende Antwort liefert. Der Hebel liegt in neuen oder überarbeiteten Inhalten, nicht in der Feinarbeit an bestehenden Spitzenplätzen.
- Schritt 1Fragen sammelnZwanzig bis vierzig Fragen aus Vertriebsgesprächen, Kundenservice, Webinaren und Ausschreibungen, im Wortlaut der Zielgruppe und ohne euren Markennamen.
- Schritt 2Ausgangswert festhaltenJede Frage einmal in den gängigen Assistenten stellen oder automatisiert abfragen lassen. Für jede Frage notieren: genannt ja oder nein, Position, eigene Seite zitiert, welche fremden Quellen zitiert werden.
- Schritt 3Nach Erwähnungen sortierenFragen mit null oder fast null Nennungen stehen oben. Das ist eure Lückenliste.
- Schritt 4Fremde Quellen ansehenFür die obersten Fragen prüfen, welche Seiten stattdessen zitiert werden und was sie gemeinsam haben: Format, Länge, Belege, Autorenschaft.
Welche Lücke lohnt einen eigenen Beitrag?
Nicht jede. Eine Lücke lohnt einen eigenen Beitrag, wenn vier Bedingungen zusammenkommen: Ihr kommt bei der Frage praktisch nicht vor, die Frage liegt nah an eurem Angebot, ihr kennt das Format, das die KI dort zitiert, und ihr habt zu der Frage eigene Substanz. Fehlt die Substanz, schreibt ihr den elften austauschbaren Text zum Thema.
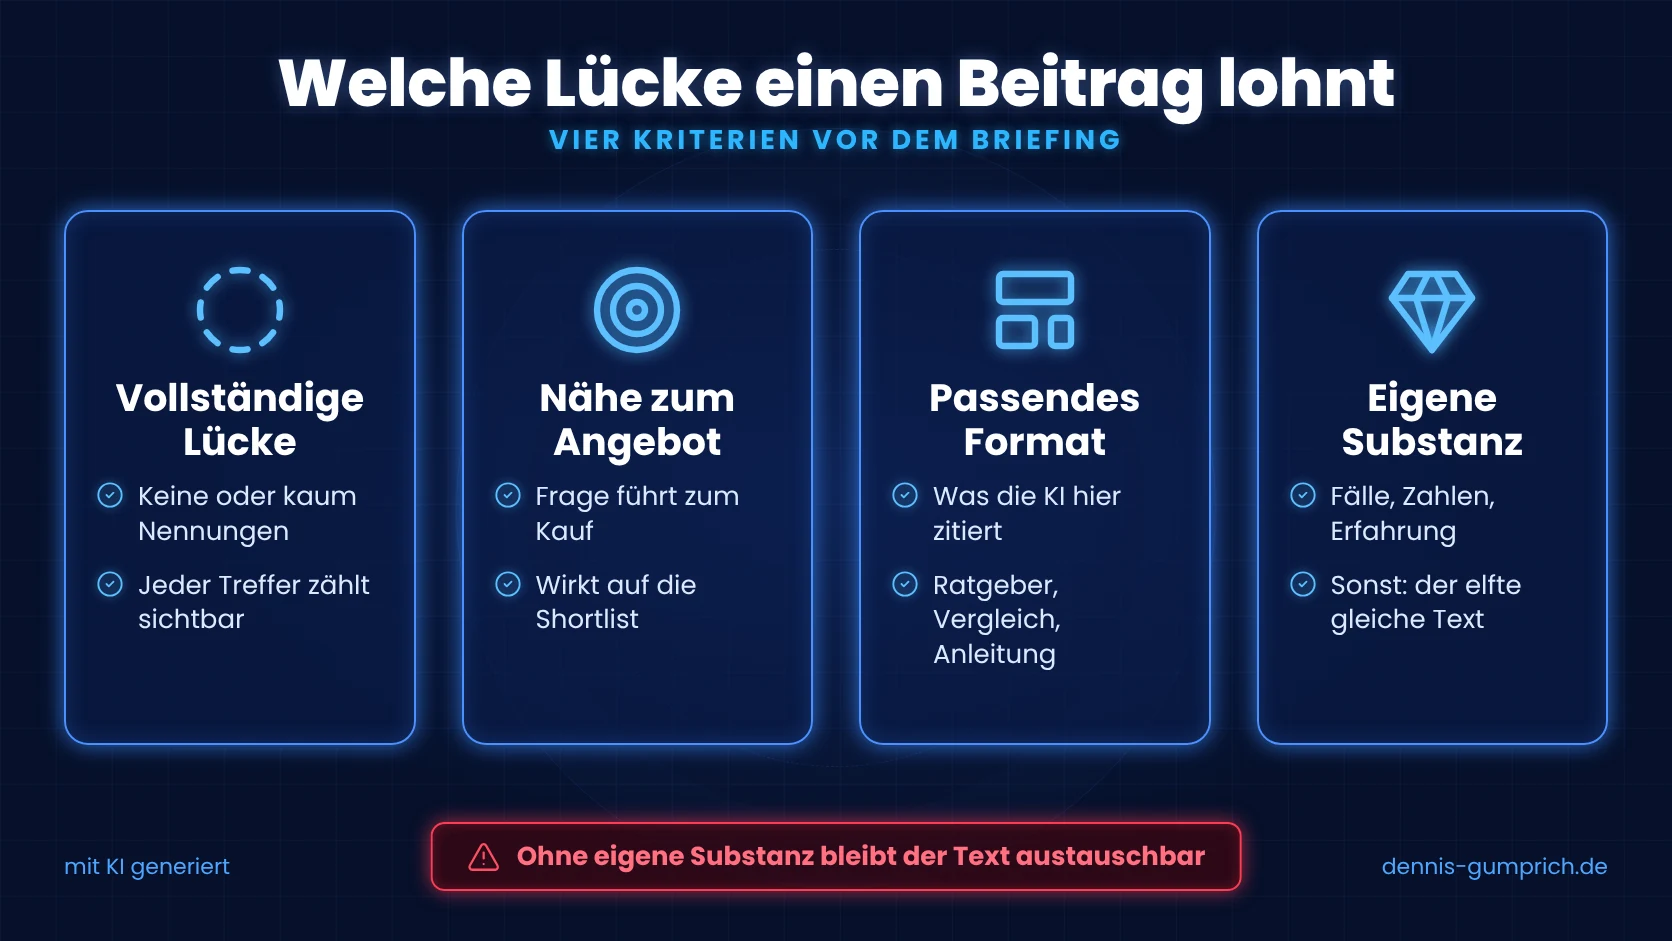
| Kriterium | Prüffrage | Woran ihr es erkennt |
|---|---|---|
| Vollständige Lücke | Kommen wir bei dieser Frage vor? | keine oder fast keine Nennung in allen gemessenen Antworten |
| Nähe zum Angebot | Führt die Frage zu dem, was wir verkaufen? | Vertrieb hört die Frage im Erstgespräch oder kurz vor der Entscheidung |
| Passendes Format | Welche Art Seite zitiert die KI hier? | die fremden Quellen sind Ratgeber, Vergleiche oder Anleitungen |
| Eigene Substanz | Haben wir dazu etwas, das sonst niemand hat? | Projektwerte, Kundenfälle, eigene Tests, belastbare Erfahrung im Team |
Das zweite Kriterium wird oft unterschätzt. Eine Nennung bei einer allgemeinen Wissensfrage bringt Reichweite. Eine Nennung bei einer Frage, die Interessenten kurz vor einer Entscheidung stellen, bringt Gespräche. Wenn ihr wenig Kapazität habt, beginnt mit den Lücken, die der Vertrieb aus seinen Gesprächen kennt.
Das vierte Kriterium ist das härteste. Wer zu einer Frage keine eigene Erfahrung, keine eigenen Zahlen und keinen dokumentierten Fall hat, kann zwar einen guten Text schreiben, aber keinen besseren als die Quellen, die bereits zitiert werden. In diesem Fall lohnt es sich, zuerst Substanz zu schaffen, etwa durch eine kleine Auswertung oder ein Gespräch mit Kundinnen und Kunden, und den Beitrag danach zu planen.
Wie hilft KI bei der Auswahl, ohne zu raten?
Indem sie auf eure Messdaten zugreift, statt aus allgemeinem Wissen zu antworten. Ein KI-Assistent, der an eure Messung der KI-Sichtbarkeit angebunden ist, kann die Lückenliste auswerten, die Kriterien anwenden und einen Beitrag mit Begründung vorschlagen. Prüft dabei immer, ob die Empfehlung auf euren Zahlen beruht.
Eine gute Empfehlung erkennt ihr an drei Dingen. Sie nennt die konkrete Frage aus eurem Katalog. Sie nennt die Zahl der Antworten, in denen ihr fehlt, und die Quellen, die stattdessen zitiert werden. Und sie begründet, warum das gewählte Format zur Frage passt. Fehlt eines davon, hat der Assistent geraten. Viele Assistenten zeigen inzwischen an, welche Daten sie abgerufen haben. Ein kurzer Blick darauf ersetzt eine lange Diskussion über die Qualität der Empfehlung.
Aus der Empfehlung entsteht dann das Briefing, und in das Briefing gehört die Frage aus dem Katalog im Wortlaut der Zielgruppe. Sie ist später der Maßstab für die Prüfung. Welche weiteren Felder ein Briefing für zitierfähige Inhalte braucht, steht im Beitrag zu GEO im Content-Prozess.
Was misst ein GEO-Score?
Ein GEO-Score bewertet, wie gut eine KI einen Text verstehen, einordnen und als Quelle übernehmen kann. GEO steht für Generative Engine Optimization. Der Score setzt sich aus Teilwerten zusammen, etwa für die direkte Antwort, die Zitierfähigkeit einzelner Sätze, die Abdeckung des Themas und die Vertrauenssignale. Aussagekräftig sind die Teilwerte, nicht die Gesamtzahl.
Die einzelnen Werkzeuge gewichten unterschiedlich und benennen ihre Teilwerte verschieden. Die folgenden acht Bereiche tauchen in den meisten Bewertungen auf, weil sie sich aus der Funktionsweise von KI-Suchen ableiten. Google beschreibt zum Beispiel für AI Overviews und AI Mode ein Verfahren namens „query fan-out“: Das System stellt mehrere verwandte Suchanfragen zu Teilthemen und zieht dafür weitere Seiten heran.2 Ein Text, der mehr dieser Teilfragen beantwortet, hat mehr Gelegenheiten, gefunden zu werden.
| Teilwert | Was dahintersteckt | Prüffrage für euer Team |
|---|---|---|
| Direkte Antwort | KI-Systeme übernehmen einzelne Abschnitte, die Antwort muss am Anfang stehen | Beantwortet der erste Satz die Frage, ohne dass man weiterlesen muss? |
| Zitierfähigkeit | die KI nutzt nur Ausschnitte, Aussagen müssen ohne den Rest der Seite stimmen | Bleibt der Satz richtig, wenn man ihn herauslöst? |
| Themenabdeckung | KI-Suchen zerlegen Fragen in Teilfragen | Beantwortet der Text auch die Fragen, die danach kommen? |
| Entitäten | Fachbegriffe und Konzepte, über die eine KI ein Thema einordnet | Kommen die zentralen Begriffe vor, und werden sie erklärt? |
| E-E-A-T | Googles Begriff für Erfahrung, Fachwissen, Autorität und Vertrauenswürdigkeit | Ist erkennbar, wer schreibt, worauf sich die Aussagen stützen und wann geprüft wurde? |
| Informationsgewinn | was der Text beiträgt, das andere Quellen nicht haben | Steht hier etwas, das man nur bei uns findet? |
| Faktendichte | belegte Zahlen und benannte Quellen statt allgemeiner Behauptungen | Hat jede wichtige Aussage eine Quelle, einen Test oder ein Datum? |
| Lesbarkeit | Satzlänge und Verständlichkeit | Versteht jemand ohne Vorwissen den Text beim ersten Lesen? |
Wichtig ist außerdem, woran gemessen wird. Ein guter GEO-Score bewertet einen Text gegen eine konkrete Nutzerfrage. Erkennt das Werkzeug die Frage automatisch, weicht sie oft leicht von der Frage aus eurem Katalog ab. Setzt sie deshalb von Hand auf genau die Frage, bei der ihr fehlt. Dann misst der Score, ob der Text eure Lücke schließt, und nicht, ob er irgendeine verwandte Frage beantwortet.
In eigener Sache
Ich arbeite für contentbird. Dort gibt es einen GEO-Score, der Texte direkt im Editor gegen eine konkrete Nutzerfrage bewertet, die Teilwerte einzeln ausweist und Verbesserungen mit Aufwand und erwarteter Wirkung vorschlägt. Die KI-Sichtbarkeit misst Erwähnungen, Position und Zitierungen für einen Katalog von Fragen ohne Markennamen im Vergleich zu Wettbewerbern, und der KI-Chat kann auf diese Messdaten zugreifen. Die Beispielwerte zum KI-Entwurf weiter unten stammen aus einer Live-Prüfung in einer Product Masterclass. Der Score ist eine Einschätzung, keine Garantie für eine Zitierung.
Wie lest ihr einen GEO-Score richtig?
Über das Muster der Teilwerte, nicht über die Gesamtzahl. Eine 55 kann bedeuten, dass ein Text gut geschrieben, aber unbelegt ist, oder dass er belegt, aber schwer zugänglich ist. Beides verlangt völlig unterschiedliche Arbeit. Wer nur auf die Gesamtzahl schaut, weiß, dass etwas fehlt, aber nicht, wer im Team es liefern muss.
Bei KI-Entwürfen zeigt sich fast immer dasselbe Muster. Ein Beispiel aus einer Live-Prüfung im Oktober 2026: Ein KI-Entwurf zur Frage, wie man aus einem Briefing Blogartikel und Social-Media-Posts erstellt, erreichte insgesamt 55 von 100 Punkten. Die Lesbarkeit lag bei 100, die direkte Antwort bei 80, die Zitierfähigkeit und die Themenabdeckung bei 75, die Entitäten bei 70. E-E-A-T lag bei 10: keine Links zu Primärquellen, keine externen Links, kein ausgewiesener Autor.
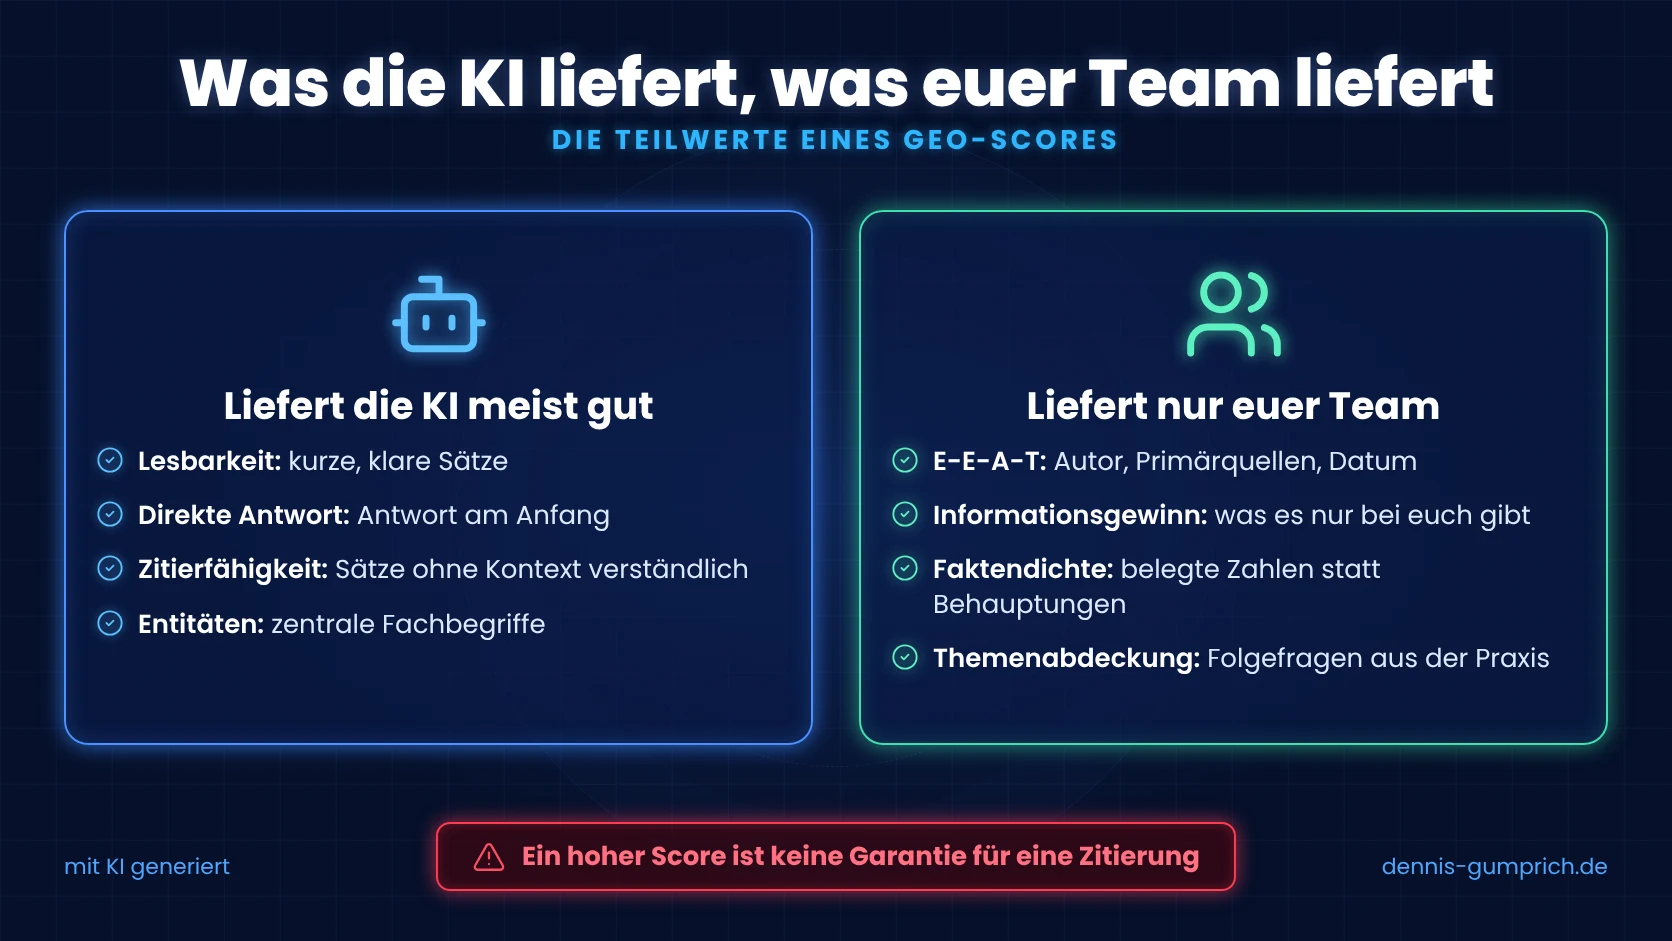
Das Muster ist typisch und sagt mehr als die Zahl. Die Teilwerte, die von Sprache und Struktur abhängen, sind hoch. Die Teilwerte, die von Erfahrung und Belegen abhängen, sind niedrig. Die Folgerung ist eindeutig: Dieser Text braucht keine weitere Umformulierung durch die KI, sondern Material aus dem Team. Drei Muster helfen beim Lesen.
Viele Werkzeuge listen zusätzlich die Fragen, die ein Leser zum Thema ebenfalls stellt, und markieren, ob der Text sie abdeckt, teilweise abdeckt oder auslässt. Diese Liste ist für die Überarbeitung oft wertvoller als der Score selbst. Im Beispiel waren Pflichtbausteine eines Briefings, der Ablauf bis zum fertigen Artikel und typische Fehler vollständig abgedeckt. Kanalunterschiede und ein konkretes Beispiel waren nur teilweise abgedeckt. Eine Frage fehlte ganz: Wie werden Rollen, Freigaben und Zuständigkeiten im Team organisiert? Für eine Marketingleitung ist genau das oft die wichtigste.
Welche Verbesserungen setzt ihr zuerst um?
Zuerst die schnellen Verbesserungen, die die Redaktion in wenigen Minuten erledigt, dann die Substanz, für die ihr Material aus Fachabteilung, Vertrieb oder Projekten braucht. Die schnellen Verbesserungen heben den Score sichtbar. Den Unterschied zu anderen Quellen machen aber fast immer die Verbesserungen, die Recherche brauchen.
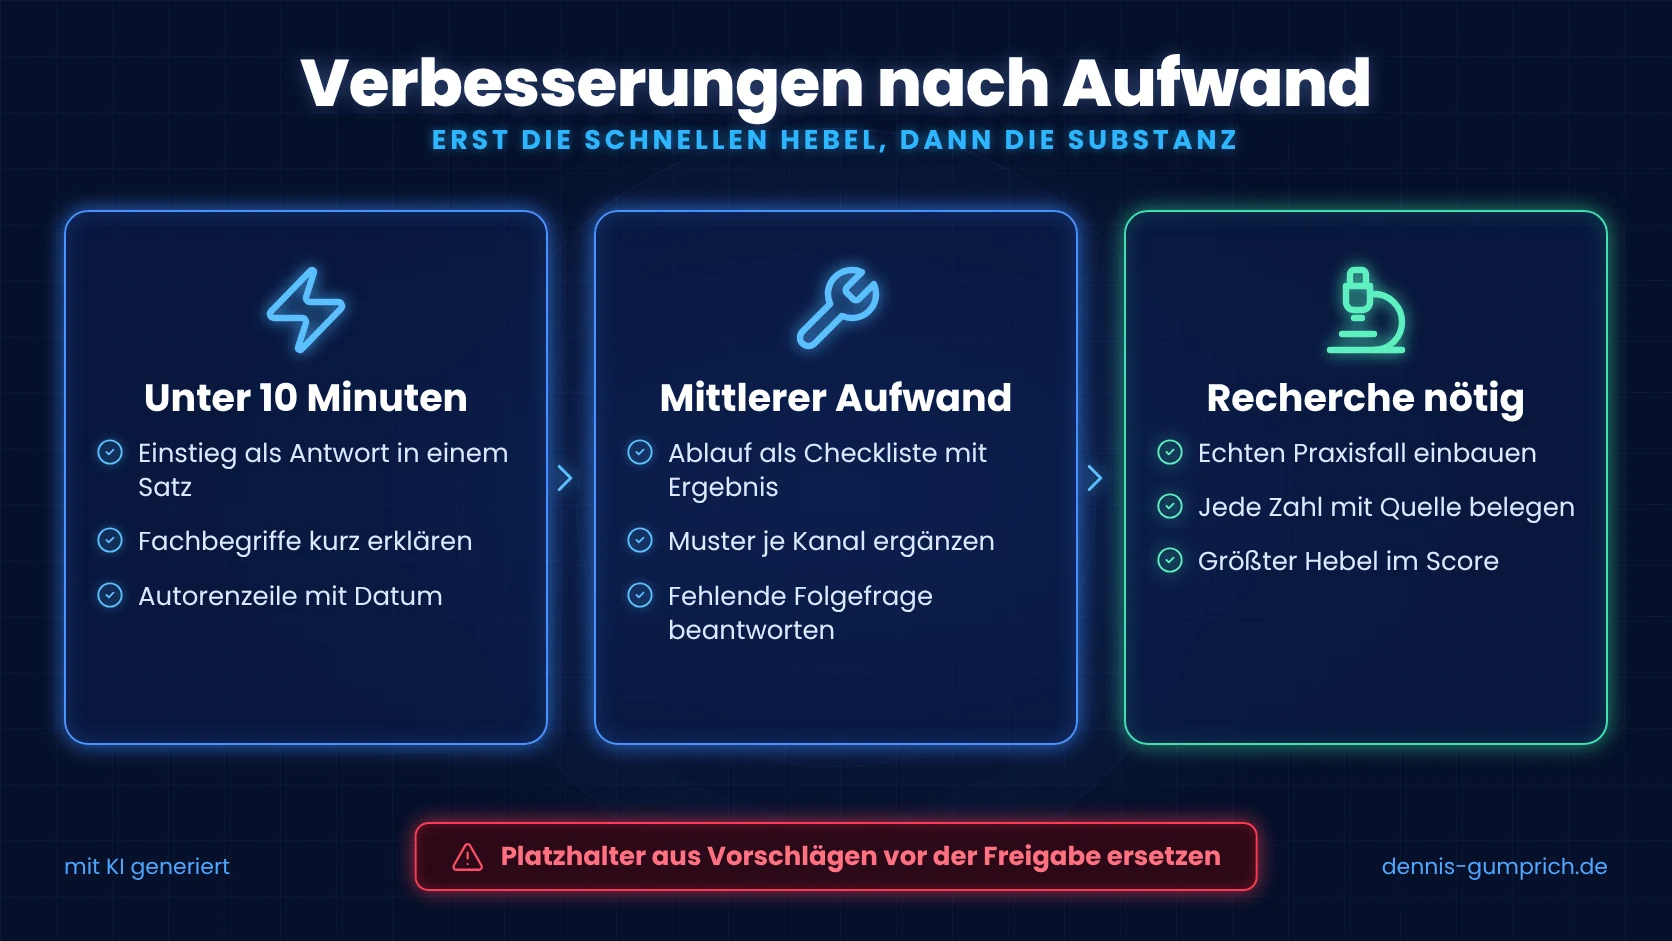
Gute GEO-Werkzeuge schlagen konkrete Verbesserungen vor und nennen für jede den Aufwand und die erwartete Wirkung auf den Score. Das verändert die Diskussion im Team. Statt darüber zu streiten, ob ein Text gut genug ist, entscheidet ihr, welche Verbesserungen ihr umsetzt und wer sie liefert.
| Aufwand | Typische Verbesserungen | Wer sie liefert |
|---|---|---|
| Unter 10 Minuten | Einstieg als Antwort in einem Satz, Fachbegriffe beim ersten Auftreten erklären, Autorenzeile mit Name, Rolle und Aktualisierungsdatum; im Beispiel zusammen 3,4 Punkte | Redaktion, oft per Klick übernommen |
| Mittlerer Aufwand | Ablauf als Checkliste mit Ergebnis pro Schritt, je Kanal ein eigenes Muster für Einstieg, Länge und Ziel, fehlende Folgefrage beantworten | Redaktion mit Fachwissen zum Thema |
| Recherche nötig | hypothetisches Beispiel durch echten oder anonymisierten Praxisfall ersetzen, jede Behauptung mit benannter Quelle oder eigenem Test belegen; im Beispiel bis zu 2,6 Punkte je Vorschlag | Fachabteilung, Vertrieb, Kundenservice |
Im Beispiel standen insgesamt 13,4 Punkte aus allen offenen Vorschlägen im Raum. Die drei schnellen Verbesserungen brachten davon einen Teil, die meisten Punkte lagen bei Informationsgewinn und Faktendichte. Das ist kein Zufall. Was die KI nicht liefern kann, ist genau das, was einen Text zitierwürdig macht.
Eine Auswertung des Toolanbieters Sistrix passt zu diesem Muster. Für „GEO-Mythen im Datencheck: Was 96.418 URLs über AI-Citations verraten“ vom Oktober 2026 haben Johannes Beus und Julia Weißbach 96.418 URLs aus 17.380 Domains im deutschsprachigen Raum untersucht. Verglichen wurden zitierte und nicht zitierte Seiten derselben Domain in ChatGPT, AI Mode und AI Overviews im zweiten Quartal 2026. Für eine Autorenbox mit Foto ermittelt die Analyse einen Faktor von 1,4, für ein sichtbares Update-Datum und für mindestens zehn externe Links jeweils 1,3, wobei 1,0 keinen Unterschied bedeutet. Ein sichtbares Update-Datum hatten nur 5 Prozent der Seiten. Autor und externe Links fehlten dem KI-Entwurf im Beispiel, das Aktualisierungsdatum stand unter den schnellen Verbesserungen. Nehmt alle drei als feste Angaben in eure Prüfung vor der Freigabe auf. Einschränkend gilt: Es ist die Analyse eines Toolanbieters, und sie zeigt Zusammenhänge, keine Ursachen.
Häufiger Fehler an dieser Stelle: Vorschläge mit Platzhaltern ungeprüft übernehmen. Ein Vorschlag wie „Von [Name], [Rolle]. Zuletzt aktualisiert am [Datum]“ ist eine Vorlage, kein fertiger Satz. Wird er per Klick übernommen und nicht ausgefüllt, steht der Platzhalter nach der Freigabe live im Text.
Was kann nur euer Team liefern?
Alles, was es nur bei euch gibt: dokumentierte Fälle aus Projekten, eigene Zahlen mit Zeitraum, Ergebnisse interner Tests, die Erfahrung einer namentlich genannten Fachperson und Quellen, die ihr geprüft habt. Dieses Material liegt selten in der Redaktion, sondern in Vertrieb, Kundenservice, Projektteams und Produktmanagement. Die Aufgabe der Redaktion ist, es dort abzuholen.
Ein Beispiel für den Unterschied. Ein KI-Entwurf schreibt: „Nehmen wir an, das Briefing fokussiert das Problem, dass Marketingteams zu viel Zeit in Abstimmungen verlieren.“ Eine überarbeitete Fassung schreibt, was in einem echten oder anonymisierten Projekt passiert ist: wie viele Felder das Briefing hatte, welche Inhalte daraus entstanden sind und wie sich die Zeit bis zur Freigabe verändert hat. Der zweite Absatz ist kein besserer Stil. Er ist eine Information, die eine KI nirgendwo anders findet.
Google stützt diese Richtung in seinem Leitfaden „Website für generative KI-Funktionen in der Google Suche optimieren“ vom Juli 2026. Die Optimierung für KI-Antworten ist dort Teil der allgemeinen Suchoptimierung, und Google rät, eigene Erfahrung und Fachwissen einzubringen, statt Bekanntes zu wiederholen. Eine llms.txt-Datei nutzt Google nach eigener Aussage nicht, ein spezielles Schema braucht es nicht, und Texte eigens für KI umzuschreiben ist nicht nötig. Steckt die Zeit deshalb in das Material aus Vertrieb, Kundenservice und Projekten, nicht in technische Sonderwege. Einschränkend gilt: Das ist eine Plattformrichtlinie für die Google Suche und gilt nicht automatisch für ChatGPT oder Perplexity.
- Quelle 1VertriebWelche Einwände und Fragen kommen zu diesem Thema? Welche Kundensituationen lassen sich anonymisiert beschreiben?
- Quelle 2KundenserviceWo hakt es in der Praxis? Welche Fehler sehen die Kolleginnen und Kollegen immer wieder?
- Quelle 3Projekte und ProduktmanagementWelche Werte gibt es zu Dauer, Aufwand oder Ergebnis? Welche Tests wurden intern gemacht?
- Quelle 4Fachperson als Autorin oder AutorWer steht mit Namen und Rolle für den Inhalt? Wer prüft ihn beim nächsten Update?
Damit das nicht jedes Mal neu verhandelt werden muss, lohnt eine einfache Regel: Jeder Beitrag zu einer Lücke aus dem Fragenkatalog enthält mindestens eine Angabe, die es nur bei euch gibt. Wer für dieses Material zuständig ist, steht im Briefing. Wie ihr eure Fachleute dabei entlastet, statt sie mit Schreibaufträgen zu belasten, steht in Übergaben zwischen Marketing und Fachabteilung.
Wer prüft was vor der Freigabe?
Die Redaktion prüft den GEO-Score und setzt die schnellen Verbesserungen um. Die Fachabteilung bestätigt Zahlen und Aussagen und liefert die Substanz. Die Freigabe entscheidet, ob der Text die vereinbarte Mindeststufe erreicht oder mit einem dokumentierten Grund darunter veröffentlicht wird. So bleibt die Prüfung schnell und trotzdem verbindlich.
| Rolle | Aufgabe | Zeitpunkt |
|---|---|---|
| Redaktion | Prüffrage auf die Frage aus dem Katalog setzen, Score prüfen, schnelle Verbesserungen umsetzen, Platzhalter ausfüllen | nach dem ersten Entwurf |
| Fachabteilung | Praxisfall, Zahlen und Quellen liefern, fachliche Aussagen bestätigen | vor der zweiten Prüfung |
| Freigabe | Mindeststufe prüfen, Ausnahmen mit Grund dokumentieren | vor der Veröffentlichung |
| GEO-Verantwortung | Mindeststufe festlegen, Messung nach Veröffentlichung, Ergebnis an Redaktion zurückspielen | monatlich |
Eine feste Mindeststufe klingt streng, spart aber Abstimmung. Ohne sie wird bei jedem Text neu diskutiert, ob 62 Punkte gut genug sind. Mit ihr ist klar, was fehlt und wer es liefert. Wichtig ist die Ausnahme: Manche Texte sollen gar nicht in KI-Antworten auftauchen, etwa Pressemitteilungen mit kurzer Halbwertszeit. Für sie gilt die Stufe nicht, und das steht im Briefing. Wie ihr Prüfkriterien insgesamt so aufbaut, dass Freigaben nicht länger dauern, steht in der Checkliste vor der Freigabe.
Wie messt ihr, ob der Text wirkt?
Mit derselben Frage aus demselben Katalog, monatlich und mit Datum dokumentiert. Nach der Veröffentlichung beobachtet ihr, ob Erwähnungsrate und Zitierrate bei dieser Frage steigen und ob eure Seite unter den zitierten Quellen auftaucht. Rechnet mit Wochen, nicht mit Tagen, weil überarbeitete Seiten erst neu erfasst werden müssen.
Der Ausgangswert vor der Veröffentlichung ist dabei unverzichtbar. Ohne ihn lässt sich später nicht zeigen, was der Text bewirkt hat. Haltet für jede Frage fest, wie oft ihr vor der Überarbeitung genannt wurdet, welche Quellen zitiert wurden und welchen Score der Text vor und nach der Überarbeitung hatte. Diese drei Werte reichen, um im Quartals-Review zu entscheiden, ob der Ansatz trägt.
Erwartet keine gleichmäßige Kurve. KI-Antworten schwanken von Abfrage zu Abfrage, und einzelne Sprünge haben oft Ursachen, die nichts mit eurem Text zu tun haben, etwa eine Änderung im Modell oder neue Quellen von anderen. Bewertet deshalb Trends über mehrere Monate und nicht einzelne Messpunkte. Wie ihr diese Messung in ein Reporting für die Geschäftsführung übersetzt, steht in Content-Wirkung belegen.
Fünf Fehler beim Weg vom KI-Entwurf zum zitierfähigen Text
- Den Score als Garantie lesenEin hoher Score macht einen Text zitierfähig, nicht automatisch zitiert. Ob er wirkt, zeigt erst die Messung in den KI-Antworten.
- Gegen die falsche Frage prüfenWird der Text gegen eine automatisch erkannte, allgemeine Frage bewertet, misst der Score nicht die Lücke, die ihr schließen wolltet. Setzt die Frage aus eurem Katalog.
- Nur die schnellen Verbesserungen umsetzenAutorenzeile und Antwortsatz sind schnell erledigt und heben den Score. Den Unterschied zu anderen Quellen machen Praxisfälle und Belege.
- Die KI weiter umformulieren lassenWenn Sprache und Struktur bereits hoch bewertet sind, bringt eine weitere Fassung aus der KI kaum Punkte. Gebraucht wird Material aus dem Team.
- Ohne Ausgangswert startenWer vor der Überarbeitung nicht dokumentiert, in welchen Antworten er vorkommt, kann später keine Wirkung belegen.
Wann lohnt sich der Aufwand für euch noch nicht?
Wenn eure Zielgruppe vor einer Entscheidung kaum recherchiert, wenn ihr weniger als zwei bis drei Inhalte im Monat veröffentlicht oder wenn es zu euren Kernfragen im Haus noch keine eigene Substanz gibt. Im letzten Fall ist der erste Schritt nicht die Prüfung, sondern das Sammeln von Fällen und Zahlen.
Bei wenigen Veröffentlichungen reicht es, die Prüffragen aus der Tabelle oben von Hand anzuwenden und zwei- bis dreimal im Jahr zu messen. Ein Werkzeug mit automatisiertem Score und laufender Messung lohnt sich, wenn mehrere Personen, Agenturen und Fachabteilungen Inhalte liefern und ihr eine einheitliche Messlatte braucht. Und wenn bei euch heute unklar ist, wer Inhalte beauftragt und wer sie freigibt, gehört diese Frage vor alles andere. Wie ihr solche Abläufe aufbaut, steht in Content Operations: was es ist und wie ihr es aufbaut.
Selbstcheck: Wie zitierfähig sind eure Texte vor der Freigabe?
Setzt Haken bei allem, was auf euch zutrifft.
kurze Einordnung, warum unsere Texte in ChatGPT und Co. selten genannt werden:
Unsere KI-gestützten Entwürfe sind gut lesbar und beantworten die richtigen Fragen. Was ihnen fehlt, sind eigene Fälle, eigene Zahlen, Quellen und eine erkennbare Autorenschaft. Genau danach wählen KI-Suchen ihre Quellen aus. Solange wir dasselbe sagen wie zehn andere Seiten, werden wir nicht zitiert.
Vorschlag: Wir messen für einen festen Katalog von Kundenfragen, wo wir in KI-Antworten fehlen, wählen die Lücken mit dem größten Bezug zu unserem Angebot und prüfen jeden Text vor der Freigabe gegen genau diese Frage. Für jeden Beitrag liefert die Fachabteilung mindestens einen Praxisfall oder eine eigene Zahl.
Der Aufwand liegt bei wenigen Stunden pro Beitrag zusätzlich. Die Wirkung messen wir monatlich mit denselben Fragen und bewerten sie im Quartal.
Fazit: Die KI schreibt den Text, euer Team macht ihn zitierwürdig
Ein KI-Entwurf ist ein guter Anfang. Er ist lesbar, gegliedert und beantwortet die Frage. Für eine Nennung in ChatGPT, Perplexity oder den AI Overviews reicht das selten, weil viele Seiten dasselbe sagen. Der Unterschied entsteht bei Erfahrung, Belegen und Informationen, die es nur bei euch gibt, und genau dort zeigt ein GEO-Score, wo euer Team ansetzen muss.
Zusammen mit der Messung in den KI-Antworten entsteht daraus ein Kreislauf: Lücke finden, passenden Beitrag planen, Text vor der Freigabe prüfen, Wirkung nachmessen. Statt Bauchgefühl habt ihr eine Messlatte vor der Veröffentlichung, statt endloser Feedbackschleifen eine Liste mit klaren Zuständigkeiten.
Häufige Fragen
Garantiert ein hoher GEO-Score, dass ChatGPT meinen Text zitiert?
Nein. Der Score misst die Zitierfähigkeit vor der Veröffentlichung, also ob der Text die Eigenschaften mitbringt, die KI-Systeme bei Quellen bevorzugen. Ob er tatsächlich zitiert wird, hängt auch von Indexierung, Wettbewerb und Erwähnungen außerhalb eurer Website ab. Deshalb gehören Prüfung und Messung zusammen.
Was ist der Unterschied zwischen einem SEO-Score und einem GEO-Score?
Ein SEO-Score bewertet einen Text für Rankings in der klassischen Ergebnisliste, etwa über Suchbegriffe, Struktur und technische Merkmale. Ein GEO-Score bewertet, ob eine KI den Text versteht und einzelne Abschnitte als Antwort übernehmen kann. Beides ergänzt sich, weil KI-Suchen auf gut indexierte Seiten zugreifen.
Wie viele Fragen braucht ein guter Fragenkatalog?
Zwanzig bis vierzig Fragen ohne Markennamen sind ein guter Start. Weniger bildet eure Zielgruppe zu grob ab, deutlich mehr lässt sich monatlich kaum sauber auswerten. Gute Quellen sind Vertriebsgespräche, Kundenservice, Suchdaten aus der Search Console und die Fragen, die in Webinaren und Ausschreibungen immer wieder kommen.
Kann ich auch bestehende Texte prüfen?
Ja, und das ist oft der schnellste Hebel. Bestehende Seiten haben bereits Rankings und Verlinkungen. Ergänzt dort Antwortsätze, Belege und Autorenangaben und messt danach, ob sich die Nennungen verändern. Eine Content-Inventur hilft bei der Auswahl der Seiten.
Welche Mindeststufe sollte ein Text erreichen?
Das hängt von Werkzeug und Thema ab, deshalb gibt es keine allgemeingültige Zahl. Bewährt hat sich, nach den ersten zehn bis zwanzig geprüften Texten eine Stufe festzulegen, die ihr mit vertretbarem Aufwand erreicht, und sie nach einem Quartal anhand der Messung zu überprüfen. Wichtiger als die Zahl ist, dass Ausnahmen begründet und dokumentiert werden.
Wie schnell sehe ich Veränderungen in den KI-Antworten?
Rechnet mit Wochen, nicht mit Tagen. Überarbeitete Seiten müssen erst neu erfasst werden, und KI-Antworten schwanken von Abfrage zu Abfrage. Messt deshalb monatlich mit demselben Fragenkatalog, dokumentiert das Datum jeder Messung und bewertet die Entwicklung über ein Quartal.
Wo verliert euer Content-Prozess heute Zeit?
In 30 Minuten schauen wir gemeinsam darauf, wo euch heute unnötige Abstimmungen, manuelle Aufgaben, Toolwechsel oder wiederkehrende Content-Arbeit Zeit kosten.
Wenn du wissen willst, wo ihr in KI-Antworten fehlt, schauen wir uns eure wichtigsten Kundenfragen an und klären, welche Lücken sich mit dem geringsten Aufwand schließen lassen und was euer Team dafür liefern muss.
Content-Prozess in 30 Minuten analysieren Kostenfrei. Du nimmst konkrete Ansatzpunkte mit, die ihr intern direkt weiterverwenden könnt.
Dennis Gumprich
Dennis begleitet Marketing- und Kommunikationsteams bei der Frage, wie generative KI in bestehende Content-Prozesse passt, ohne Qualität, Markensprache und Freigaben zu untergraben. Schwerpunkte: Content Operations, AI Governance und Toolauswahl in Mittelstand und Konzern.
Transparenzhinweis: Dennis arbeitet für contentbird, einen Anbieter von KI-gestützter Content-Software. Produkterwähnungen sind im Beitrag gekennzeichnet. Mehr über Dennis · LinkedIn
Weiterlesen
Quellen
- Pranjal Aggarwal, Vishvak Murahari, Tanmay Rajpurohit, Ashwin Kalyan, Karthik Narasimhan, Ameet Deshpande: GEO: Generative Engine Optimization, Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD 2024), Fassung vom 28. Juni 2024: Zitate, Statistiken und Quellenangaben erhöhten die Sichtbarkeit um bis zu rund 40 Prozent, Keyword Stuffing schnitt schlechter ab als der unveränderte Text. Abgerufen am 31. Oktober 2026.
- Google Search Central: AI features and your website, Dokumentation, Stand 10. Dezember 2025: Beschreibung von „query fan-out“ in AI Overviews und AI Mode sowie Indexierung als Voraussetzung. Abgerufen am 31. Oktober 2026.
- Google Search Central: Creating helpful, reliable, people-first content, Leitfaden, Stand 5. Oktober 2026: Definition von E-E-A-T und Empfehlung zu Autorenangaben. Abgerufen am 31. Oktober 2026.
- Rand Fishkin, SparkToro: NEW Research: AIs are highly inconsistent when recommending brands or products, Studie vom 27. Januar 2026, rund 600 Freiwillige, 2.961 Antworten von ChatGPT, Claude und Google: gleiche Markenliste in weniger als einem von 100 Fällen. Abgerufen am 31. Oktober 2026.
- Johannes Beus, Julia Weißbach, Sistrix: GEO-Mythen im Datencheck: Was 96.418 URLs über AI-Citations verraten, Analyse vom 22. Oktober 2026, 96.418 URLs aus 17.380 Domains im DACH-Raum, zweites Quartal 2026, ChatGPT, AI Mode und AI Overviews, Vergleich zitierter und nicht zitierter Seiten derselben Domain (Faktor 1,0 bedeutet keinen Unterschied): Autorenbox allgemein 1,3, mit Foto 1,4, sichtbares Update-Datum 1,3 bei nur 5 Prozent der Seiten, mindestens zehn externe Links 1,3, wissenschaftliche Quelle 1,2, llms.txt ohne messbaren Effekt. Analyse eines Toolanbieters, Korrelation, keine Ursache. Abgerufen am 31. Oktober 2026.
- Google Search Central: Website für generative KI-Funktionen in der Google Suche optimieren, Leitfaden, Stand 15. Juli 2026: Optimierung für KI-Funktionen als Teil der allgemeinen Suchoptimierung, llms.txt wird nicht genutzt, kein spezielles Schema, kein Umschreiben nur für KI, eigene Erfahrung und Fachwissen statt Wiederholung, viele Seiten für jede Suchvariante gelten als Spam. Plattformrichtlinie für die Google Suche. Abgerufen am 31. Oktober 2026.
Entstehung dieses Beitrags
Dieser Beitrag ist unter Einsatz von KI entstanden, auf Grundlage der GEO Produkt Masterclass vom 29. Oktober 2026. Struktur, Recherche und Formulierungsentwürfe wurden KI-gestützt erarbeitet. Fachliche Einordnung, Prüfung der Aussagen und die finale Fassung liegen bei Dennis Gumprich.
Zur Belastbarkeit der Aussagen
Belegt sind die Effekte von Zitaten, Statistiken, Quellenangaben und Keyword Stuffing durch die GEO-Studie, das Verfahren „query fan-out“ durch die Google-Dokumentation, die Bedeutung von E-E-A-T und Autorenangaben durch den Google-Leitfaden und die Schwankung von KI-Antworten zwischen Abfragen durch die SparkToro-Studie, außerdem die Zusammenhänge zwischen Autorenbox, Update-Datum, externen Links und Zitierungen durch die Sistrix-Auswertung (Analyse eines Toolanbieters, Korrelation, keine Ursache) sowie Googles Einordnung der KI-Optimierung als allgemeine Suchoptimierung durch den Leitfaden zu generativen KI-Funktionen (Plattformrichtlinie). Die Beispielwerte stammen aus einer Live-Prüfung im Oktober 2026 und beziehen sich auf einen bestimmten Text. KI-Antworten schwanken, eigene Werte können deutlich abweichen. Die Teilwerte eines GEO-Scores sind Ableitungen aus der Funktionsweise von KI-Suchen und aus Studien, keine von den Anbietern bestätigten Rankingfaktoren. Die Effekte aus der GEO-Studie wurden unter Testbedingungen gemessen. Priorisierung, Rollen und Mindeststufe sind Arbeitsmodelle aus der Beratungspraxis. Stand 31. Oktober 2026.