
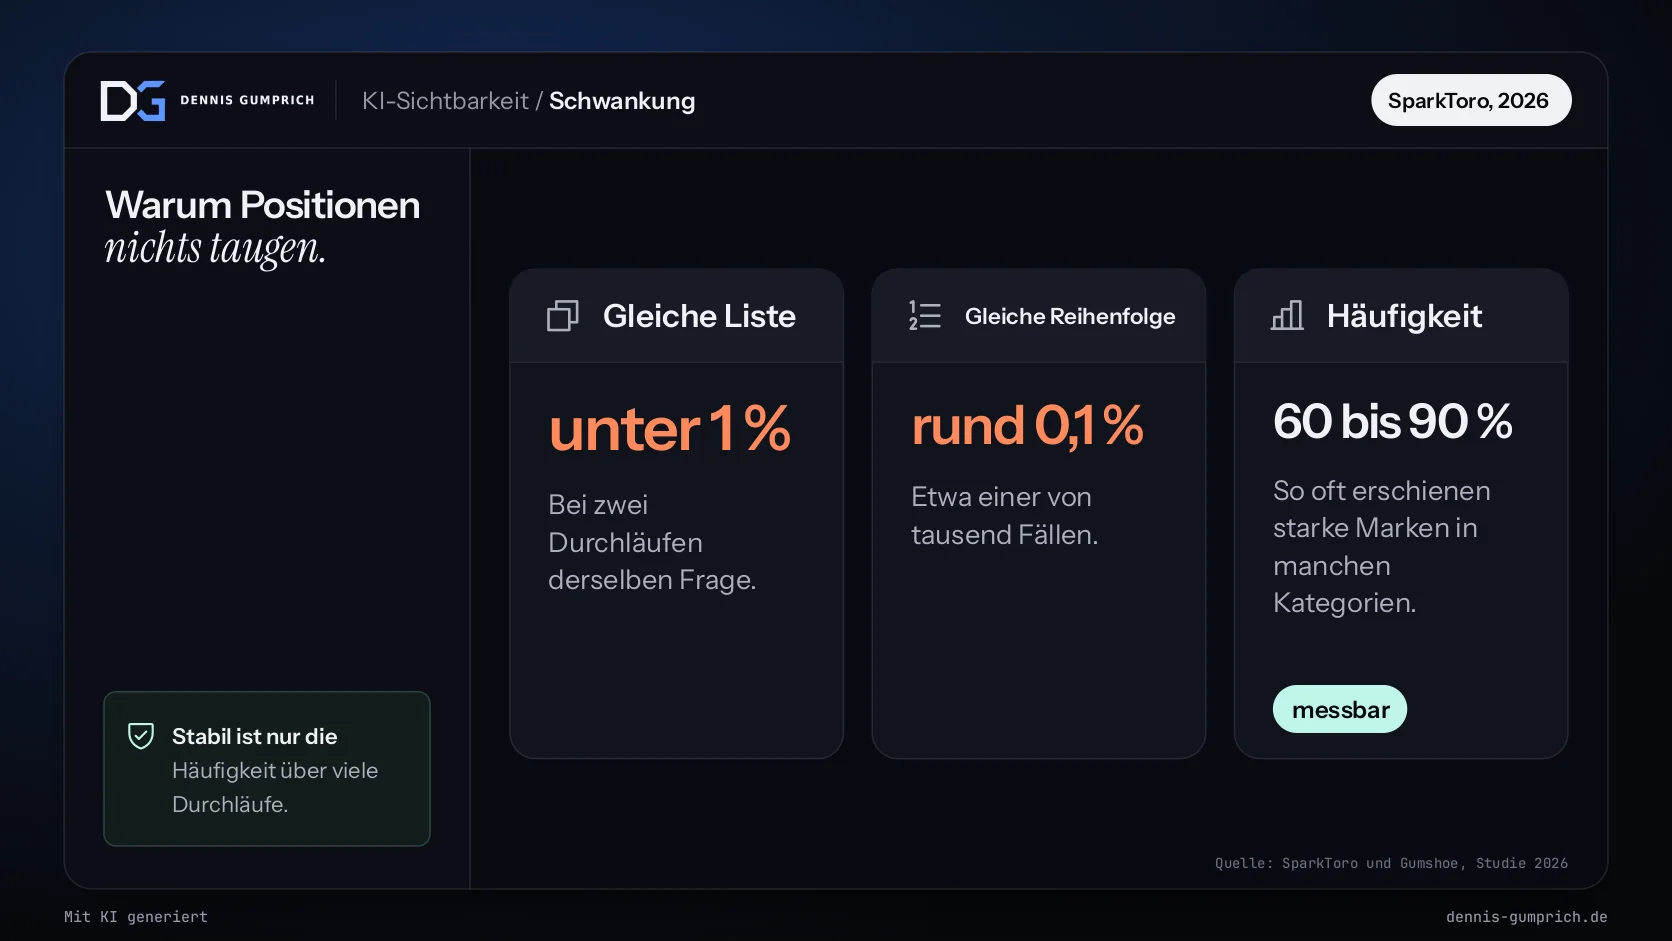
der Fälle lieferte eine KI bei wiederholter Frage dieselbe Empfehlungsliste. Positionen in KI-Antworten taugen deshalb nicht als Kennzahl.Quelle: SparkToro und Gumshoe
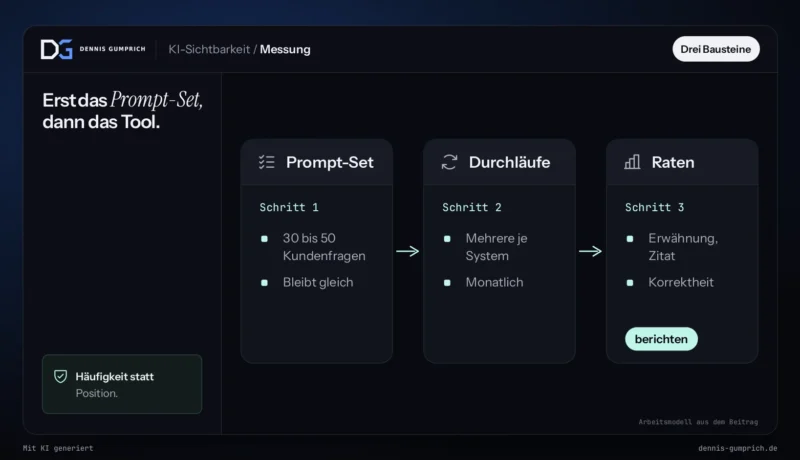
KI-Sichtbarkeit messt ihr mit einem festen Prompt-Set aus 30 bis 50 Fragen, die eure Zielgruppe wirklich stellt, mehreren Durchläufen je Frage und Raten statt Positionen. Denn KI-Antworten schwanken von Abfrage zu Abfrage stark. Die wichtigsten Kennzahlen sind Präsenz laut Search Console, Erwähnungsrate, Zitierrate und Korrektheit. Für den Start reicht eine Tabelle. Ein Tool lohnt sich, wenn das Prompt-Set wächst oder ihr mehrere Märkte messt.
Dieser Beitrag zeigt, mit welchen Tools und Prompt-Sets ihr messt. Welche Kennzahlen in euer Reporting gehören und wie ihr sie an Geschäftsziele bindet, klärt Sichtbarkeit ohne Klick messen.
Was bedeutet es, KI-Sichtbarkeit zu messen?
KI-Sichtbarkeit messen heißt, regelmäßig zu erheben, ob und wie eure Marke in Antworten von KI-Systemen vorkommt: ob sie angezeigt, genannt, verlinkt und richtig beschrieben wird. Gemessen wird über ein festes Set von Fragen, nicht über einzelne Stichproben.
Für Google gibt es eine eigene Datenquelle: Die Search Console zeigt Impressionen in AI Overviews und im KI-Modus. Für ChatGPT, Perplexity, Gemini oder Copilot gibt es nichts Vergleichbares. Dort messt ihr von außen, indem ihr Fragen stellt und die Antworten auswertet. Genau das tun auch alle Tools. Google weist im eigenen Leitfaden darauf hin, dass kein Werkzeug von Dritten Zugriff auf die internen Ranking- oder KI-Systeme hat.
Warum Klicks allein nicht reichen und wie ihr die Werte der Geschäftsführung berichtet, steht in Sichtbarkeit ohne Klick. Dieser Beitrag geht einen Schritt weiter: wie ihr das Prompt-Set aufbaut und woran ihr ein Tool erkennt, das belastbare Zahlen liefert.
Warum taugen Positionen in KI-Antworten nicht als Kennzahl?
Weil KI-Antworten bei jeder Abfrage anders ausfallen. In einer Studie von SparkToro und Gumshoe erschien dieselbe Empfehlungsliste bei zwei Durchläufen in weniger als einem von hundert Fällen, dieselbe Liste in derselben Reihenfolge nur in etwa einem von tausend.
Für die Studie haben 600 Freiwillige zwölf identische Fragen in ChatGPT, Claude und Googles KI gestellt, insgesamt rund 3.000 Durchläufe. Auch die Länge der Listen schwankte von zwei bis zu mehr als zehn Einträgen. Stabil war dagegen, wie oft eine Marke über viele Durchläufe auftauchte: In manchen Kategorien erschienen einzelne Marken in 60 bis 90 Prozent der Antworten.
Daraus folgt die wichtigste Regel für jede Messung: Häufigkeit statt Position. Ein Tool, das euch „Platz 2 in ChatGPT“ meldet, beschreibt eine einzelne Antwort, keine Lage.
Wie baut ihr ein Prompt-Set auf?
Mit 30 bis 50 Fragen, die eure Zielgruppe wirklich stellt, in vier Gruppen: Kategoriefragen ohne Markennamen, Problemfragen, Vergleichsfragen und Fragen zu eurer Marke. Das Set bleibt über Monate gleich, sonst sind die Werte nicht vergleichbar.
| Gruppe | Beispiel | Anteil | Was sie zeigt |
|---|---|---|---|
| Kategorie | Welche Software eignet sich für Redaktionsplanung im Mittelstand? | rund 40 % | Ob ihr ohne Namensnennung empfohlen werdet |
| Problem | Wie verkürzen wir Freigaben im Marketing? | rund 30 % | Ob eure Inhalte als Quelle dienen |
| Vergleich | Was unterscheidet Anbieter A von Anbieter B? | rund 15 % | Wie ihr gegenüber Wettbewerbern eingeordnet werdet |
| Marke | Ist Anbieter A DSGVO-konform? | rund 15 % | Ob Angaben über euch stimmen |
Die Fragen kommen aus Vertrieb, Service und Ausschreibungen, nicht aus Keyword-Tools. Formuliert sie so, wie Menschen sie in einen Assistenten tippen: als ganzen Satz, oft mit Kontext zur eigenen Lage. Legt außerdem fest, welche Systeme ihr messt, in welcher Sprache und für welches Land. Und stellt jede Frage mehrmals, mindestens drei Durchläufe je System und Monat. Erst aus vielen Antworten entsteht eine Rate.
Welche Kennzahlen gehören in den Bericht?
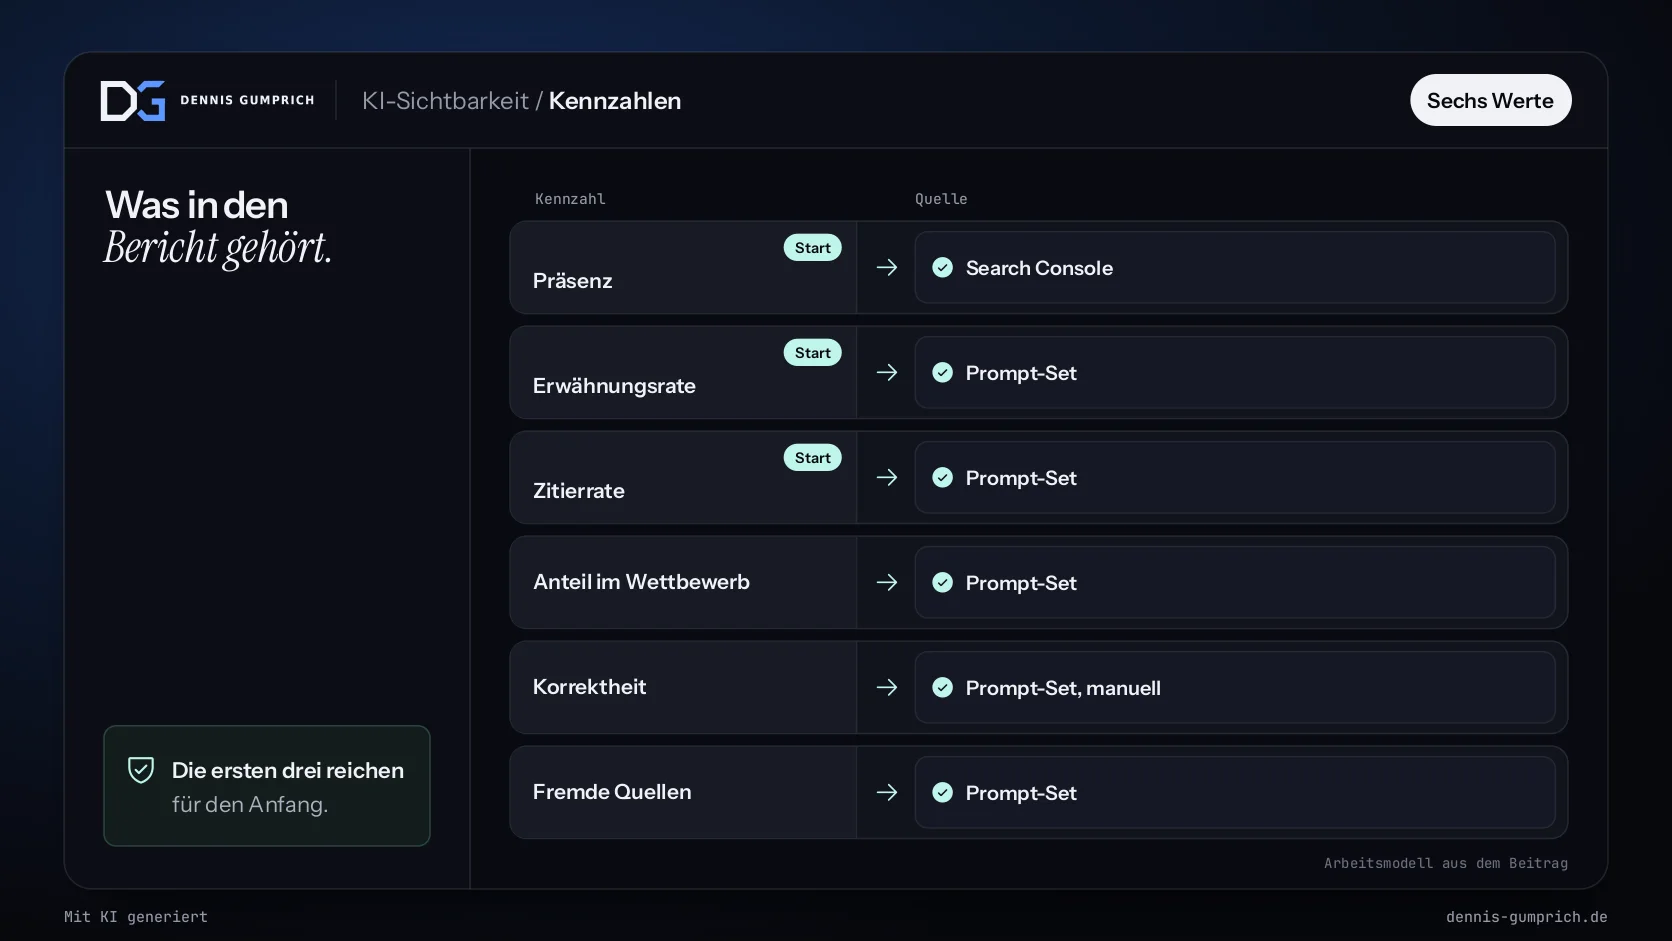
Sechs Kennzahlen decken das Wesentliche ab: Präsenz in Googles KI-Funktionen, Erwähnungsrate, Zitierrate, Anteil gegenüber Wettbewerbern, Korrektheit und die meistzitierten fremden Quellen. Die ersten drei reichen für den Anfang.
| Kennzahl | Rechnung | Quelle |
|---|---|---|
| Präsenz | Impressionen in KI-Funktionen, Anteil an allen Impressionen | Search Console |
| Erwähnungsrate | Antworten mit Markennennung durch alle Antworten | Prompt-Set |
| Zitierrate | Antworten mit Link zu euch durch alle Antworten | Prompt-Set |
| Anteil im Wettbewerb | Eure Nennungen durch alle Nennungen eurer Wettbewerber | Prompt-Set |
| Korrektheit | Markenfragen mit falscher oder veralteter Angabe | Prompt-Set, manuell geprüft |
| Fremde Quellen | Welche Websites am häufigsten zitiert werden | Prompt-Set |
Die letzte Kennzahl wird oft übersehen und ist für die Planung besonders nützlich. Wenn ein Fachportal oder ein Verzeichnis in vielen Antworten zitiert wird, ist eine Erwähnung dort oft wirksamer als ein weiterer eigener Beitrag. Mehr dazu in Digital PR für KI-Sichtbarkeit.
Welche Arten von Tools gibt es?
Vier Wege: die eigene Tabelle, KI-Module in SEO-Suiten, spezialisierte Tools für Prompt-Tracking und Content-Plattformen mit eingebauter Sichtbarkeitsanalyse. Sie unterscheiden sich vor allem darin, wie viele Abfragen sie automatisieren und wie gut sie in eure Arbeit eingebunden sind.
| Weg | Stärke | Grenze | Passt für |
|---|---|---|---|
| Eigene Tabelle | Volle Kontrolle, keine Kosten | Hoher manueller Aufwand | Bis etwa 50 Fragen, ein Markt |
| KI-Modul einer SEO-Suite | Verknüpfung mit Rankings und Keywords | Oft vorgegebene Fragen | Teams mit bestehender SEO-Suite |
| Spezialisiertes Tracking-Tool | Viele Durchläufe, viele Systeme | Eigene Datenwelt neben dem Prozess | Viele Märkte und Sprachen |
| Content-Plattform mit Analyse | Messung und Überarbeitung an einem Ort | Funktionsumfang je Anbieter verschieden | Teams, die Ergebnisse direkt umsetzen wollen |
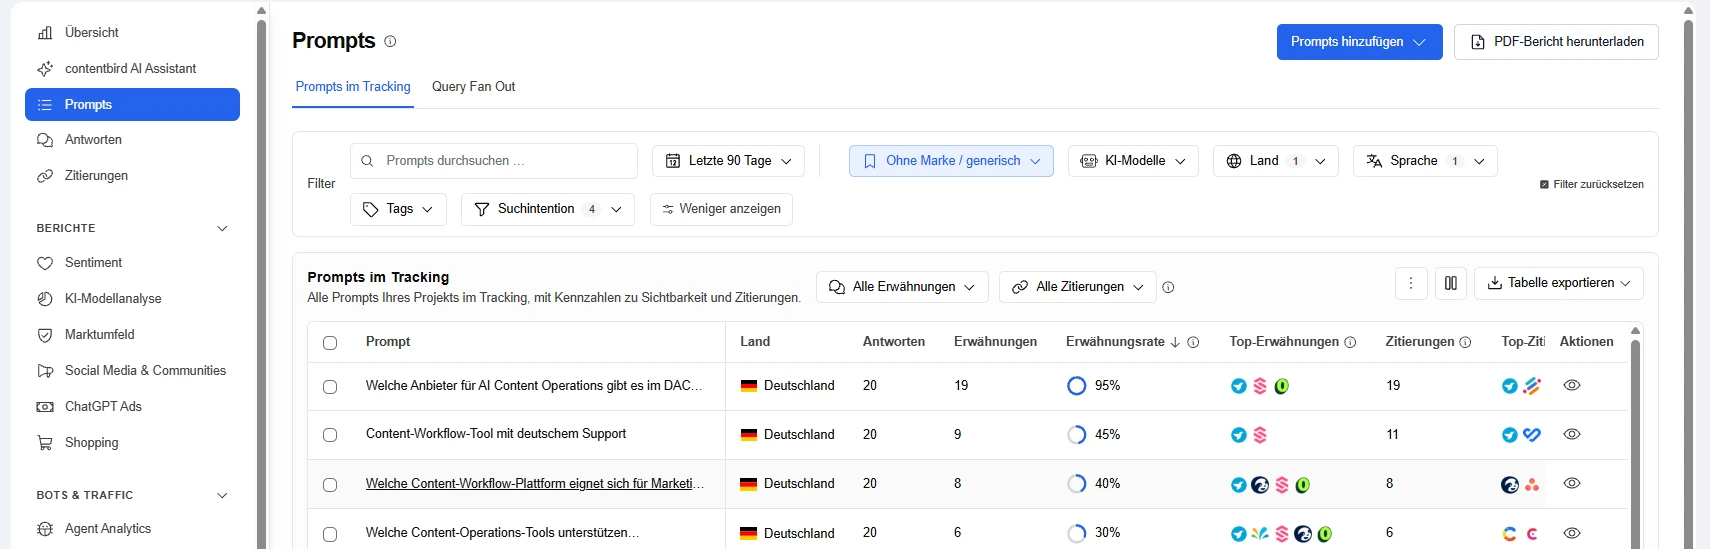
Angesehen und genutzt habe ich unter anderem Prompt-Tracking und Share-of-Voice-Auswertungen von LLM Pulse und Peak. Auf Ebene des einzelnen Textes nutze ich den GEO-Score von contentbird, der Zitierbarkeit, Faktendichte, Struktur und E-E-A-T auf einer Skala von 0 bis 100 bewertet.
Mein Messaufbau: fünf KI-Modelle als Standard, der Vergleich mit Wettbewerbern, ein monatlicher PDF-Bericht und jeden Monat neue Prompt-Vorschläge auf Basis der eigenen Inhalte.
Woran erkennt ihr ein gutes Tool für KI-Sichtbarkeit?
An acht Prüffragen, die jeder Anbieter in der Demo beantworten können sollte. Die wichtigsten drei: Wie viele Durchläufe gibt es je Frage? Weist das Tool Raten oder Positionen aus? Könnt ihr euer eigenes Prompt-Set verwenden?
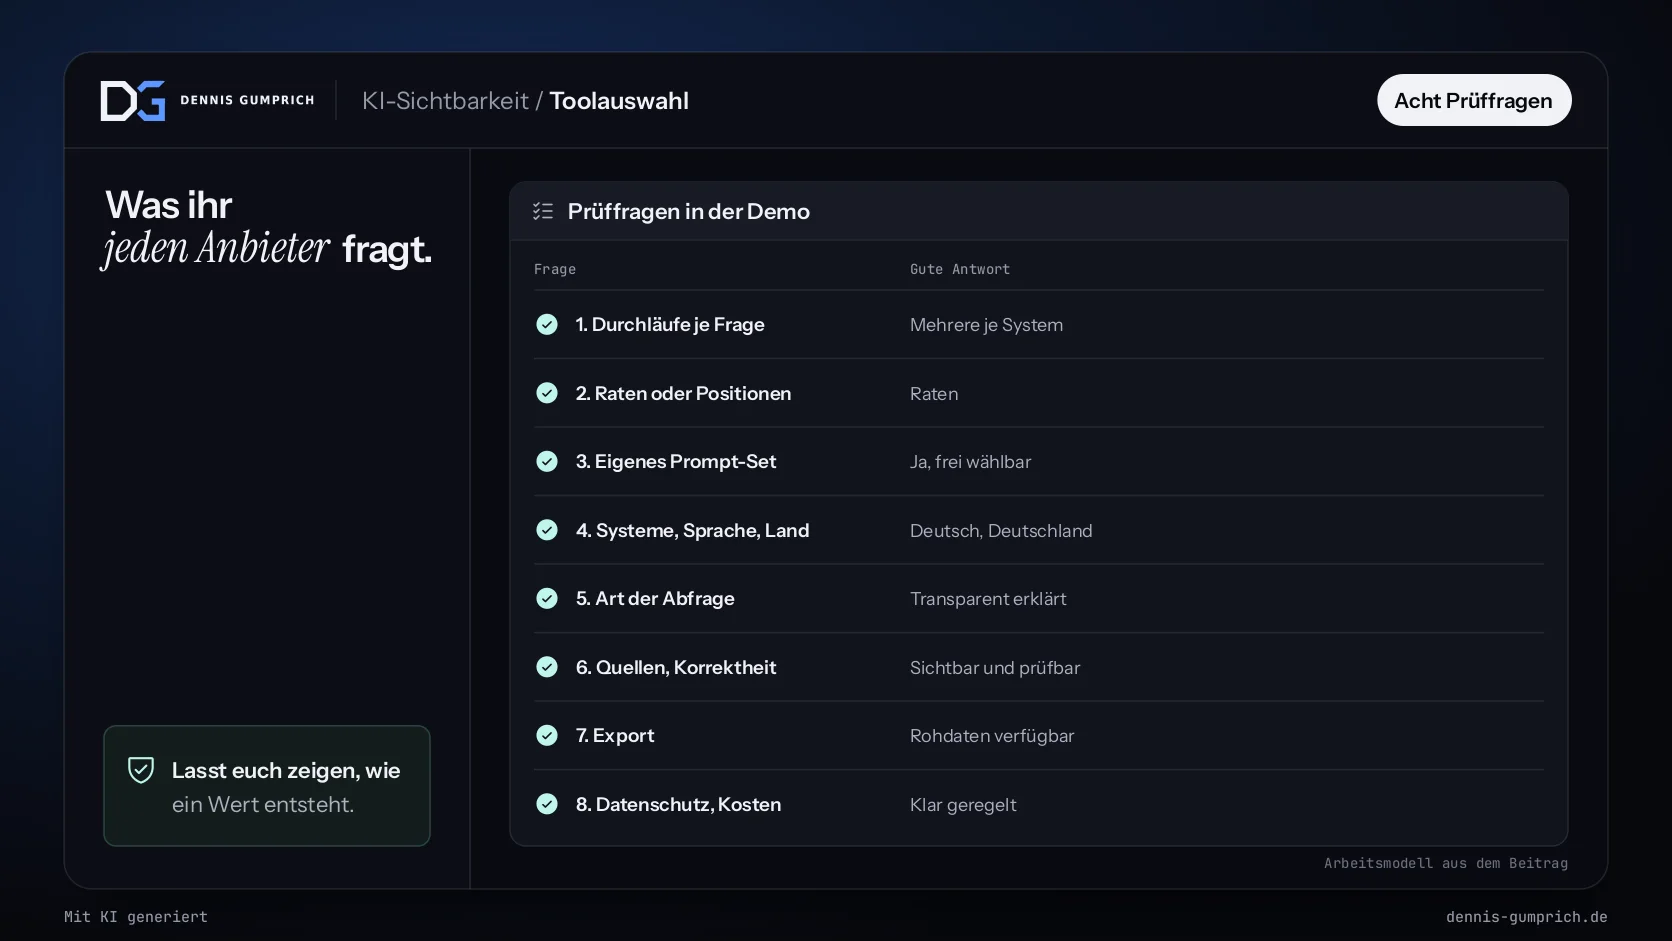
- Frage 1Durchläufe je FrageEin Durchlauf ist eine Stichprobe. Fragt, wie oft jede Frage je System und Zeitraum gestellt wird.
- Frage 2Raten statt PositionenGute Tools zeigen, in wie viel Prozent der Antworten ihr vorkommt. Positionen allein sind Rauschen.
- Frage 3Eigenes Prompt-SetVorgegebene Fragen aus Keyword-Daten treffen selten, was eure Kunden fragen.
- Frage 4Systeme, Sprache, LandWelche Assistenten werden abgefragt, und lässt sich Deutsch und Deutschland einstellen?
- Frage 5Art der AbfrageFragt, ob über Schnittstellen oder über die Oberfläche gemessen wird. Antworten können sich zwischen beiden Wegen unterscheiden.
- Frage 6Quellen und KorrektheitZeigt das Tool, welche Websites zitiert werden, und lässt sich prüfen, ob Angaben stimmen?
- Frage 7Export und AnbindungLassen sich Rohdaten exportieren oder in euer Reporting übernehmen?
- Frage 8Datenschutz und KostenWo werden Daten verarbeitet, und wie rechnet der Anbieter ab: je Frage, je Durchlauf oder pauschal?
Ein „Sichtbarkeitsindex“ als einzelne Zahl ist für den Einstieg bequem, aber nur so gut wie seine Rechnung. Lasst euch zeigen, aus welchen Fragen und Durchläufen er entsteht. Wie ihr Anbieter grundsätzlich vergleicht und Pilotphasen anlegt, beschreibt Pilot und Rollout.
Eigenbau oder Tool?
Startet mit einer Tabelle, wenn ihr bis etwa 50 Fragen in einem Markt messt. Wechselt zu einem Tool, wenn das Set wächst, mehrere Länder dazukommen oder die manuelle Erhebung mehr als einen Arbeitstag im Monat kostet.
Die Tabelle hat einen Vorteil, der oft unterschätzt wird: Ihr lest die Antworten selbst. Dabei fällt auf, welche Quellen zitiert werden, wie euer Unternehmen beschrieben wird und wo Angaben falsch sind. Diese Einsichten gehen verloren, wenn ein Tool nur noch einen Wert ausgibt. Auch mit Tool solltet ihr deshalb jeden Monat eine Stichprobe von Antworten lesen.
Fünf Fehler beim Messen von KI-Sichtbarkeit
- Einzelne Abfragen zitierenEin Screenshot aus ChatGPT ist eine Anekdote. Entscheidungen brauchen Raten über viele Durchläufe.
- Das Prompt-Set laufend ändernNeue Fragen machen Monatswerte unvergleichbar. Ändert das Set höchstens im Quartal und dokumentiert jede Änderung.
- Nur Markenfragen messenFragen mit eurem Namen zeigen nicht, ob ihr empfohlen werdet. Kategoriefragen ohne Namen sind aussagekräftiger.
- Tool-Werte verschiedener Anbieter vergleichenJeder Index rechnet anders. Vergleicht nur Werte aus derselben Quelle über die Zeit.
- Messen ohne KonsequenzJede Auswertung braucht eine Maßnahmenliste: welche Seite überarbeitet, welche Erwähnung angestrebt wird.
Selbstcheck: Messt ihr KI-Sichtbarkeit belastbar?
Setzt Haken bei allem, was auf euch zutrifft.
kurze Einordnung zur Messung unserer Sichtbarkeit in KI-Antworten:
KI-Antworten schwanken stark. In einer Studie wiederholte sich dieselbe Empfehlungsliste in weniger als einem von hundert Fällen. Einzelne Abfragen oder Positionen sagen deshalb wenig. Belastbar ist, wie oft wir über viele Fragen und Durchläufe genannt werden.
Ich schlage vor, mit einem festen Set von 30 bis 50 Kundenfragen und einer Tabelle zu starten und monatlich Erwähnungs- und Zitierrate zu erheben. Über ein Tool entscheiden wir, wenn das Set wächst oder weitere Märkte dazukommen.
Fazit: Erst das Prompt-Set, dann das Tool
KI-Sichtbarkeit lässt sich messen, aber nicht mit einzelnen Abfragen und nicht mit Positionen. Belastbar sind Raten über ein festes Prompt-Set, mehrere Systeme und viele Durchläufe. Das Set ist eure Aufgabe, kein Tool nimmt sie euch ab. Wer es sauber aufbaut, kann mit einer Tabelle beginnen und später ohne Bruch zu einem Tool wechseln. Wer mit dem Tool beginnt, misst oft die Fragen des Anbieters statt die eigenen.
Häufige Fragen
Wie misst man KI-Sichtbarkeit?
Mit einem festen Set von Fragen, die ihr regelmäßig in mehreren KI-Systemen stellt. Ausgewertet wird, in wie viel Prozent der Antworten eure Marke genannt und verlinkt wird. Für Google ergänzt der KI-Bericht der Search Console die Messung.
Was ist Prompt Tracking?
Prompt Tracking bezeichnet das regelmäßige, automatisierte Stellen festgelegter Fragen an KI-Systeme und das Auswerten der Antworten. Es ist der Kern der meisten Tools für KI-Sichtbarkeit.
Welches Tool ist das beste für KI-Sichtbarkeit?
Das hängt von Umfang und Arbeitsweise ab. Für bis zu 50 Fragen in einem Markt reicht eine Tabelle. Bei mehr Fragen und Märkten lohnt ein Tool, das viele Durchläufe, eigene Prompt-Sets und Raten statt Positionen bietet.
Wie viele Prompts brauche ich?
Für den Einstieg 30 bis 50 Fragen, verteilt auf Kategorie-, Problem-, Vergleichs- und Markenfragen. Wichtiger als die Menge ist, dass die Fragen aus Vertrieb und Service stammen und über Monate gleich bleiben.
Wie oft sollten wir messen?
Monatlich erheben, im Quartal bewerten. Häufiger lohnt sich selten, weil Antworten stark schwanken und überarbeitete Seiten Zeit brauchen, bis sie neu erfasst werden.
Wo verliert euer Content-Prozess heute Zeit?
In 30 Minuten schauen wir gemeinsam darauf, wo euch heute unnötige Abstimmungen, manuelle Aufgaben, Toolwechsel oder wiederkehrende Content-Arbeit Zeit kosten.
Wenn ihr eure KI-Sichtbarkeit messen wollt, bauen wir gemeinsam ein erstes Prompt-Set aus euren Kundenfragen auf.
Content-Prozess in 30 Minuten analysieren Kostenfrei. Du nimmst konkrete Ansatzpunkte mit, die ihr intern direkt weiterverwenden könnt.
Dennis Gumprich
Dennis begleitet Marketing- und Kommunikationsteams bei der Frage, wie generative KI in bestehende Content-Prozesse passt, ohne Qualität, Markensprache und Freigaben zu untergraben. Schwerpunkte: Content Operations, KI-Governance und Toolauswahl in Mittelstand und Konzern.
Transparenzhinweis: Dennis arbeitet für contentbird, einen Anbieter von KI-gestützter Content-Software. Produkterwähnungen sind im Beitrag gekennzeichnet. Mehr über Dennis · LinkedIn
Weiterlesen
Quellen
- Danny Goodwin, Search Engine Land: AI recommendation lists repeat less than 1% of the time: Study, Bericht über eine Studie von Rand Fishkin (SparkToro) und Patrick O’Donnell (Gumshoe), veröffentlicht Anfang 2026: 600 Freiwillige, 12 Fragen, rund 3.000 Durchläufe in ChatGPT, Claude und Googles KI, gleiche Liste in weniger als 1 von 100 Fällen, gleiche Reihenfolge in etwa 1 von 1.000, Empfehlung Häufigkeit statt Position. Abgerufen am 7. November 2026.
- Google Search Central: Optimizing your website for generative AI features on Google Search, Leitfaden, Stand 10. Juli 2026: Bericht zur Leistung in generativen KI-Funktionen in der Search Console, kein Werkzeug von Dritten hat Zugriff auf interne Ranking- oder KI-Systeme. Abgerufen am 7. November 2026.
- Louise Linehan, Xibeijia Guan, Ahrefs: Only 12% of AI Cited URLs Rank in Google’s Top 10 for the Original Prompt, Auswertung vom 11. August 2025: Personalisierung und Gesprächsverlauf verändern Zitate, Assistenten suchen nach Varianten einer Frage. Anbieterauswertung eines SEO-Tool-Herstellers. Abgerufen am 7. November 2026.
Entstehung dieses Beitrags
Dieser Beitrag ist unter Einsatz von KI entstanden. Struktur, Recherche und Formulierungsentwürfe wurden KI-gestützt erarbeitet. Fachliche Einordnung, Prüfung der Aussagen und die finale Fassung liegen bei Dennis Gumprich.
Zur Belastbarkeit der Aussagen
Die Zahlen zur Schwankung von KI-Antworten stammen aus einer Studie zweier Anbieter von Analyse-Tools, berichtet von einem Fachmedium. Die Aussagen zu Google stammen aus der offiziellen Dokumentation. Prompt-Set, Kennzahlen, Tool-Arten und Prüffragen sind Arbeitsmodelle aus der Beratungspraxis und keine erhobenen Messwerte. Der Hinweis auf Unterschiede zwischen Abfragen über Schnittstellen und Oberflächen ist eine Einschätzung, keine gemessene Größe.